联邦学习:数据隐私枷锁下,AI产业化的破局还是陷阱?
# 联邦学习:数据隐私枷锁下,AI产业化的破局还是陷阱?
## 摘要
当数据隐私合规成为 AI 产业发展的刚性红线,曾经被寄予厚望的联邦学习终于从实验室走到了产业落地的关口。本文梳理联邦学习的技术逻辑、落地现状、核心瓶颈,以及未来三五年的产业走向。
 传统中心化AI训练数据流转流程图
去年光是公开通报的,就有三家头部AI公司因为违规使用个人训练数据吃到百万级罚单。太多了。
市场需要一种既能用多来源的数据,又不用把原始数据集中起来的方法。联邦学习就是这么被推到台前的。
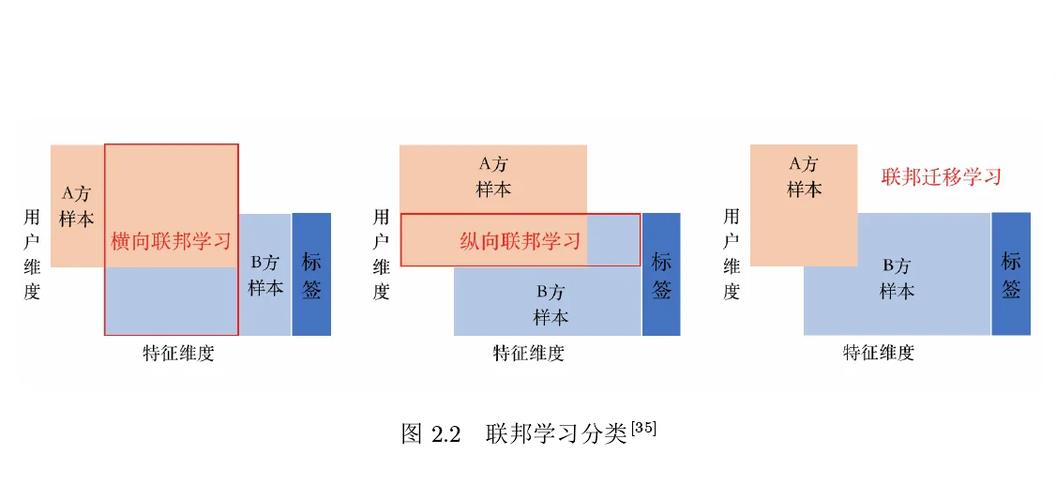 联邦学习横向纵向划分对比示意图
不过话说回来,很多人吹联邦学习是解决数据孤岛的万能药,这就是扯了。它的技术边界非常清晰:它只能解决「原始数据不能出域」的合规问题,解决不了数据本身质量差、量不够的问题。你自己手里一千条垃圾数据,就算联上一百家,出来的模型还是垃圾。这点,很多卖方案的销售绝对不会主动告诉你。
 产业落地:哪些场景真跑通了?瓶颈在哪?
现在联邦学习真落地的场景,其实都集中在强合规、对数据互通有硬需求的领域。
最成熟的是金融行业的风控建模。不少股份制银行和消费金融公司,已经用联邦学习对接运营商、电商的第三方数据,在不碰原始用户数据的前提下,把风控模型的准确率提了10%到20%,坏账率降了不少,这个是真金白银的收益。
其次是医疗行业。不同医院的病例数据涉及患者隐私,根本不能互通,用联邦学习联合训肺癌、糖尿病这类疾病的诊断模型,不用出原始数据,模型准确率比单个医院训的高很多,现在国内已经有十多家顶级三甲医院在做试点。
还有政务领域,不同部门的数据不通,用联邦学习做多部门联合建模,做城市交通预测、社保欺诈识别,也有不少试点项目。
但说实话,现在落地的项目规模都不大,大多还是POC或者小范围试用,没有大规模铺开。为什么?核心瓶颈三个:
第一是通信和计算开销太大。每次模型迭代都要所有参与方传参数,参与方越多,延迟越高,要是碰到大模型,参数规模上十亿,普通带宽根本扛不住,成本高的吓人。
第二是安全还是有漏洞。虽然原始数据不出来,但学术界已经证明,通过梯度信息反推,是可以还原出部分原始用户数据的,还是存在泄露风险。
第三是标准不统一。现在各家厂商都做自己的联邦学习框架,接口不统一,不同机构要对接,改造起来成本很高,中小企业根本掏不起这个钱。
我见过太多创业公司拿联邦学习吹概念圈融资,到头来拿不出几个真落地的项目,大多是赚一把项目钱就走。
 绕不开的风险和治理空白
除了技术瓶颈,联邦学习还有很多治理层面的问题没解决。
第一个就是投毒风险。因为没人能审查参与方的原始数据,要是有一个参与方故意把带后门的训练参数传上来,整个全局模型都会被带偏,出了问题你都找不到头,谁来负责?比如金融风控里,要是有合作方故意给劣质用户推高额度,最后坏账算谁的?现在完全没有明确的权责划分规则。
第二个就是「大吃小」的问题。数据多、质量好的大机构,训练出来的模型对大机构更有利,小机构参与进来,出了数据的价值,拿不到对应的收益,最后联邦学习变成大机构联合收割中小机构数据价值的新工具,这个问题现在也没人提。
第三个就是监管空白。现在全球范围内都没有针对联邦学习的明确监管规则,模型的安全标准是什么?数据安全责任怎么划分?出了问题怎么追责?全都是空白,很多企业不敢大规模推,就怕哪天踩红线挨罚。
 未来三五年的判断
我对联邦学习未来三五年的判断,其实很保守。
首先,它永远不会取代中心化训练,成为AI训练的主流模式。它就是一个补位的技术,只在那些「原始数据绝对不能出域」的特定场景有用,大部分场景,中心化训练的效果和成本都比联邦学习好太多。
其次,和大模型的结合会越来越多。现在很多行业客户要做自己的行业大模型微调,又不敢把自己的核心数据给大模型厂商,用联邦学习做联合微调,数据不出域就能拿到定制化模型,这个需求会快速增长,接下来一两年会有很多项目出来。
第三,标准会逐步统一,安全方案会逐步成熟。现在国内的信通院、国际的IEEE都在做联邦学习的统一标准,三五年内会出来相对通用的框架,对接成本会降下来,再加上和差分隐私、同态加密这些其他隐私计算技术结合,安全漏洞会慢慢补上。
最后,市场规模会稳步增长,但不会爆发。三五年内,联邦学习会做成一个百亿人民币级别的细分市场,主要玩家都会是现有做隐私计算、企业服务的厂商,不会出来新的万亿级巨头,毕竟需求就是这么多。
## 结语
说白了,联邦学习不是什么改变AI产业的银弹,就是行业在合规压力下,被逼出来的一个折衷方案。它有实实在在的价值,能解决真问题,但也没必要吹得神乎其神。潮水退了,剩下的才是真能落地的东西。
困局:为什么我们需要联邦学习?
说实话,现在哪家做AI的没在数据这事上犯愁? AI的性能拼到最后,就是拼数据。但现在呢? 监管一刀砍下来,原始数据根本不能随便流转。国内有《个人信息保护法》,欧盟有GDPR,随便拿用户数据跨机构合作,罚起来就是年营收的几个点,谁扛得住? 更何况,本来行业里就到处是数据孤岛。银行的数据不会给互联网公司,医院的病例不会给AI创业公司,不同省市的政务数据连部门墙都打不破,更别说拿出来训模型。 原来中心化AI训练的逻辑,就是所有原始数据集中到一个节点训练。这条路,现在在很多强合规领域,走不通了。传统中心化AI训练数据流转流程图
去年光是公开通报的,就有三家头部AI公司因为违规使用个人训练数据吃到百万级罚单。太多了。
市场需要一种既能用多来源的数据,又不用把原始数据集中起来的方法。联邦学习就是这么被推到台前的。
说人话:联邦学习的技术边界和核心逻辑
很多文章讲联邦学习堆一堆公式,没必要。说穿了,联邦学习的核心就是一句话:数据不动模型动。 原始数据永远留在自己的地盘不出域,大家各自在本地训模型,只把训好的模型参数或者梯度信息传出去给汇总方,汇总方把所有人的参数整合起来,得到一个效果更好的全局模型,再发回给所有参与方更新本地模型。全程没人能拿到别人的原始数据。 就这么简单。 按照参与方的数据特征,一般分成两种:一种是横向联邦,一种是纵向联邦。横向联邦适合大家都有相同特征、不同用户的场景,比如两家不同省份的城商行,都做信贷风控,用户不一样,要的特征都是收入、负债这些,所以把用户样本横向切分开,一起训模型。纵向联邦反过来,适合大家都有不同特征、重叠用户的场景,比如银行有用户的还款数据,电商有用户的消费数据,运营商有用户的出行数据,三方的用户有重叠,特征不一样,纵向拼起来就能训出更准的模型。联邦学习横向纵向划分对比示意图
不过话说回来,很多人吹联邦学习是解决数据孤岛的万能药,这就是扯了。它的技术边界非常清晰:它只能解决「原始数据不能出域」的合规问题,解决不了数据本身质量差、量不够的问题。你自己手里一千条垃圾数据,就算联上一百家,出来的模型还是垃圾。这点,很多卖方案的销售绝对不会主动告诉你。
产业落地:哪些场景真跑通了?瓶颈在哪?
产业落地:哪些场景真跑通了?瓶颈在哪?
现在联邦学习真落地的场景,其实都集中在强合规、对数据互通有硬需求的领域。
最成熟的是金融行业的风控建模。不少股份制银行和消费金融公司,已经用联邦学习对接运营商、电商的第三方数据,在不碰原始用户数据的前提下,把风控模型的准确率提了10%到20%,坏账率降了不少,这个是真金白银的收益。
其次是医疗行业。不同医院的病例数据涉及患者隐私,根本不能互通,用联邦学习联合训肺癌、糖尿病这类疾病的诊断模型,不用出原始数据,模型准确率比单个医院训的高很多,现在国内已经有十多家顶级三甲医院在做试点。
还有政务领域,不同部门的数据不通,用联邦学习做多部门联合建模,做城市交通预测、社保欺诈识别,也有不少试点项目。
但说实话,现在落地的项目规模都不大,大多还是POC或者小范围试用,没有大规模铺开。为什么?核心瓶颈三个:
第一是通信和计算开销太大。每次模型迭代都要所有参与方传参数,参与方越多,延迟越高,要是碰到大模型,参数规模上十亿,普通带宽根本扛不住,成本高的吓人。
第二是安全还是有漏洞。虽然原始数据不出来,但学术界已经证明,通过梯度信息反推,是可以还原出部分原始用户数据的,还是存在泄露风险。
第三是标准不统一。现在各家厂商都做自己的联邦学习框架,接口不统一,不同机构要对接,改造起来成本很高,中小企业根本掏不起这个钱。
我见过太多创业公司拿联邦学习吹概念圈融资,到头来拿不出几个真落地的项目,大多是赚一把项目钱就走。
绕不开的风险和治理空白
绕不开的风险和治理空白
除了技术瓶颈,联邦学习还有很多治理层面的问题没解决。
第一个就是投毒风险。因为没人能审查参与方的原始数据,要是有一个参与方故意把带后门的训练参数传上来,整个全局模型都会被带偏,出了问题你都找不到头,谁来负责?比如金融风控里,要是有合作方故意给劣质用户推高额度,最后坏账算谁的?现在完全没有明确的权责划分规则。
第二个就是「大吃小」的问题。数据多、质量好的大机构,训练出来的模型对大机构更有利,小机构参与进来,出了数据的价值,拿不到对应的收益,最后联邦学习变成大机构联合收割中小机构数据价值的新工具,这个问题现在也没人提。
第三个就是监管空白。现在全球范围内都没有针对联邦学习的明确监管规则,模型的安全标准是什么?数据安全责任怎么划分?出了问题怎么追责?全都是空白,很多企业不敢大规模推,就怕哪天踩红线挨罚。
未来三五年的判断
未来三五年的判断
我对联邦学习未来三五年的判断,其实很保守。
首先,它永远不会取代中心化训练,成为AI训练的主流模式。它就是一个补位的技术,只在那些「原始数据绝对不能出域」的特定场景有用,大部分场景,中心化训练的效果和成本都比联邦学习好太多。
其次,和大模型的结合会越来越多。现在很多行业客户要做自己的行业大模型微调,又不敢把自己的核心数据给大模型厂商,用联邦学习做联合微调,数据不出域就能拿到定制化模型,这个需求会快速增长,接下来一两年会有很多项目出来。
第三,标准会逐步统一,安全方案会逐步成熟。现在国内的信通院、国际的IEEE都在做联邦学习的统一标准,三五年内会出来相对通用的框架,对接成本会降下来,再加上和差分隐私、同态加密这些其他隐私计算技术结合,安全漏洞会慢慢补上。
最后,市场规模会稳步增长,但不会爆发。三五年内,联邦学习会做成一个百亿人民币级别的细分市场,主要玩家都会是现有做隐私计算、企业服务的厂商,不会出来新的万亿级巨头,毕竟需求就是这么多。
## 结语
说白了,联邦学习不是什么改变AI产业的银弹,就是行业在合规压力下,被逼出来的一个折衷方案。它有实实在在的价值,能解决真问题,但也没必要吹得神乎其神。潮水退了,剩下的才是真能落地的东西。 
