知识图谱:被大语言模型遮住光的AI基础设施
# 知识图谱:被大语言模型遮住光的AI基础设施
大模型爆火之后,知识图谱一度被贴上“过时技术”的标签。很多人认为大模型参数里已经存储了所有知识,不需要单独构建结构化的知识图谱了。但从产业落地的真实情况看,知识图谱恰恰是当前AI解决可靠性问题的核心依赖,也是被市场大大低估的AI基础设施。
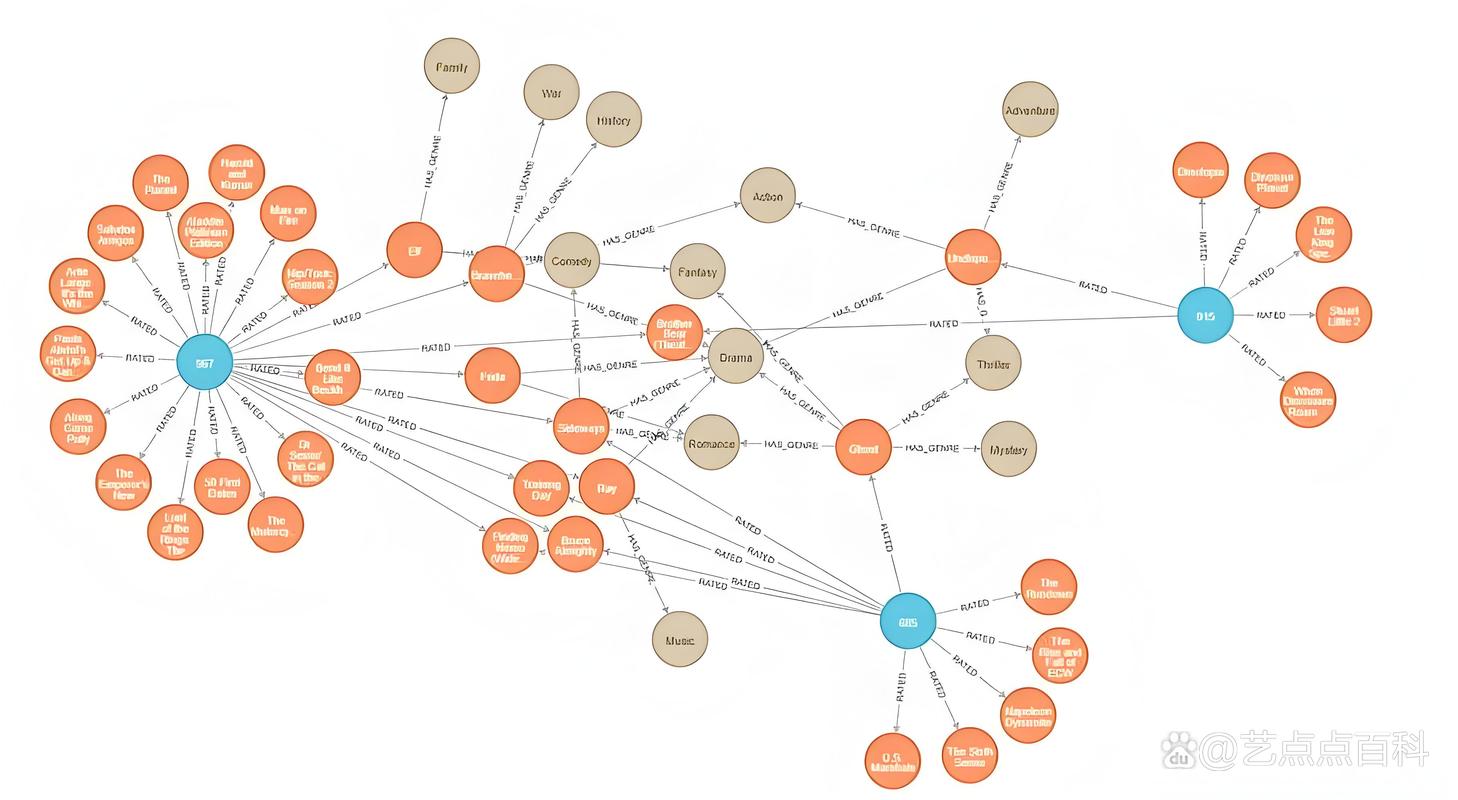 知识图谱实体关系网络示意图
很多人说大模型已经能记住所有知识了,要笔记本干嘛?你上班做报表要准确的财务数据,敢直接拿大模型生成的数用吗?银行要查借贷人有没有隐形关联,敢信大模型随口说的结果吗?说白了,对需要可靠性的产业场景来说,没有结构化的知识图谱,大模型就是个只能用来聊天的玩具。
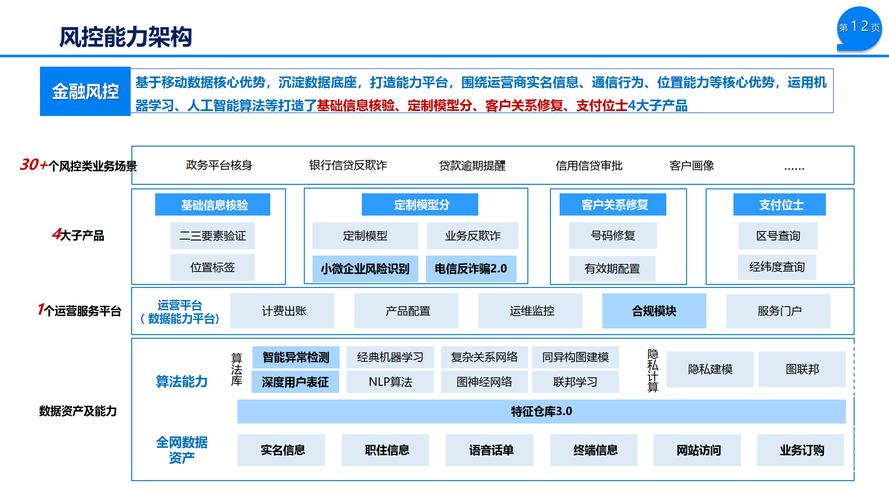 金融风控知识图谱应用架构图
这些跑通的场景其实都说明,知识图谱不是没用,是原来的落地路径错了——很多公司上来就要做通用知识图谱,要覆盖全领域的所有知识,那成本当然高到天上去,也根本用不起来。现在活的不错的知识图谱公司,都是垂直深耕某一个领域,只做领域内的知识,反而把成本降下来了,也拿到了真金白银的收入。
 未来三年:双向融合才是最终方向
大模型出来之后,知识图谱不仅不会死,反而会迎来新的机会,这个判断我跟很多产业人士聊过,大家基本都认同。
核心逻辑就是双向需求:一方面,大模型需要知识图谱解决幻觉问题,现在主流的检索增强生成技术,核心就是用知识图谱给大模型做精准的知识检索,大模型生成内容的时候,只从知识图谱里拿靠谱的知识,自然就不会瞎编了。另一方面,知识图谱需要大模型降低自己的构建成本,原来要花几十万人工标注的实体关系,现在用大模型做自动抽取和标注,准确率提升了不少,成本能降下来一大半,原来搭不起图谱的中小公司,现在也能用上了。
当然,风险也不能忽略。知识图谱把所有实体和关系都串起来,最大的问题就是数据安全和隐私。比如把社交、金融、出行的数据都做成知识图谱,只要关联起来,很容易就能定位到具体的个人,脱敏都不好使。还有知识偏见的问题,如果输入的原始知识本身就带有偏见,比如默认程序员都是男性,这个偏见就会一直留在知识图谱里,用的越久,偏见就被放大的越厉害。这些问题,都需要行业标准和监管规则慢慢跟上,不是光靠技术就能解决的。
未来三到五年,我觉得知识图谱会慢慢退到幕后,变成AI大模型体系里的核心基础设施,不会再像原来那样单独作为一个产品拿出来炒概念。但它的价值会越来越大——所有要落地的行业AI,都绕不开结构化知识这一步,知识图谱就是搭这一步的核心骨架。
原来很多快熬不下去的知识图谱创业公司,这两年又拿到融资了,为什么?就是资本也看明白了,大模型要落地,就得靠这些做知识工程和知识图谱的公司填坑。风口吹过之后,裸泳的都露出来了,真正解决问题的技术,早晚都会被重新发现。
## 结语
很多人喜欢追新,新技术出来就把老技术踩一脚,仿佛越新越好。但产业落地从来不是比谁新,是比谁能解决真问题。知识图谱不是过时的旧技术,是被大模型的光芒遮住的真需求,等热潮退了,你会发现它才是AI能落地的压舱石。
被误解的本质:知识图谱是AI的「结构化笔记本」
前阵子去北京参加一个AI产业沙龙,台上几个做大模型的创业者轮流上台,张口闭口都是“知识图谱已经被淘汰了”。底下一堆投资人跟着点头,仿佛知识图谱就是上个时代的残次品。 说实话,我听着挺别扭的。 真的不需要知识图谱了吗? 知识图谱的核心,本质上是用实体-关系-属性的图结构,把人类知识做了显式结构化存储,和大模型那种把知识藏在参数里的隐式存储,完全是两个路数。你可以把大模型当成一个博览群书但记性不好爱瞎编的文科生,知识图谱就是他兜子里揣的那个整理好了的笔记本——什么时候要查准确数据,什么时候要找人和人之间的关联,掏出来就能用,不会错。 技术边界其实很清晰:知识图谱做不了开放式创作,也没法从零生成通顺的文案,但它能保证每一条知识都是可溯源、可解释、可编辑的。这恰恰是大模型最缺的东西。知识图谱实体关系网络示意图
很多人说大模型已经能记住所有知识了,要笔记本干嘛?你上班做报表要准确的财务数据,敢直接拿大模型生成的数用吗?银行要查借贷人有没有隐形关联,敢信大模型随口说的结果吗?说白了,对需要可靠性的产业场景来说,没有结构化的知识图谱,大模型就是个只能用来聊天的玩具。
落地的真实困境:做出来容易,用起来难
不过话说回来,知识图谱这些年发展不温不火,也确实有自己的问题。我接触过不下十家做知识图谱的创业公司,大部分都遇到同一个坎:花了大半年给客户做出来一个知识图谱demo,最后就躺在客户的服务器里吃灰,根本用不起来。 问题出在哪? 第一是构建成本太高,动态更新太难。要搭一个可用的产业知识图谱,首先要解决实体抽取、实体消歧的问题。同一个“小米”,是指粮食、手机品牌还是雷军本人?不同场景下完全不一样,自动抽取的准确率哪怕到95%,剩下5%的错误放到金融、医疗场景里就是大问题,最后还是要靠人工去标,成本一下就上去了。更麻烦的是更新,知识天天变,公司的股权关系变了,商品的参数变了,疾病的诊疗方案变了,你不可能天天雇一堆人去改图谱,半年不更新,整个图谱就废了。 第二是找不到清晰的付费场景。早年很多互联网公司做知识图谱,都是用来优化搜索和推荐,这个场景没问题,但那都是大厂自己玩,创业公司挤不进去。To B的场景里,很多客户根本不知道知识图谱能帮自己解决什么问题,只是听说AI火,就想搭一个放着,最后自然用不起来。 现在用的比较好的场景,其实都集中在对关联关系有强需求的领域。比如金融的反欺诈,把企业、法人、股权、借贷信息全放到知识图谱里,一拉就能看到谁和谁是隐形关联,有没有团伙欺诈的可能。再比如电商的商品搜索,把商品的品牌、规格、属性都做成知识图谱,用户搜“2000元以内5G智能手机”,能精准给到结果,不会把不对的商品推上来。还有医疗领域,把药品、疾病、适应症的关系做成图谱,辅助临床用药审核,能大大降低出错率。金融风控知识图谱应用架构图
这些跑通的场景其实都说明,知识图谱不是没用,是原来的落地路径错了——很多公司上来就要做通用知识图谱,要覆盖全领域的所有知识,那成本当然高到天上去,也根本用不起来。现在活的不错的知识图谱公司,都是垂直深耕某一个领域,只做领域内的知识,反而把成本降下来了,也拿到了真金白银的收入。
未来三年:双向融合才是最终方向
未来三年:双向融合才是最终方向
大模型出来之后,知识图谱不仅不会死,反而会迎来新的机会,这个判断我跟很多产业人士聊过,大家基本都认同。
核心逻辑就是双向需求:一方面,大模型需要知识图谱解决幻觉问题,现在主流的检索增强生成技术,核心就是用知识图谱给大模型做精准的知识检索,大模型生成内容的时候,只从知识图谱里拿靠谱的知识,自然就不会瞎编了。另一方面,知识图谱需要大模型降低自己的构建成本,原来要花几十万人工标注的实体关系,现在用大模型做自动抽取和标注,准确率提升了不少,成本能降下来一大半,原来搭不起图谱的中小公司,现在也能用上了。
当然,风险也不能忽略。知识图谱把所有实体和关系都串起来,最大的问题就是数据安全和隐私。比如把社交、金融、出行的数据都做成知识图谱,只要关联起来,很容易就能定位到具体的个人,脱敏都不好使。还有知识偏见的问题,如果输入的原始知识本身就带有偏见,比如默认程序员都是男性,这个偏见就会一直留在知识图谱里,用的越久,偏见就被放大的越厉害。这些问题,都需要行业标准和监管规则慢慢跟上,不是光靠技术就能解决的。
未来三到五年,我觉得知识图谱会慢慢退到幕后,变成AI大模型体系里的核心基础设施,不会再像原来那样单独作为一个产品拿出来炒概念。但它的价值会越来越大——所有要落地的行业AI,都绕不开结构化知识这一步,知识图谱就是搭这一步的核心骨架。
原来很多快熬不下去的知识图谱创业公司,这两年又拿到融资了,为什么?就是资本也看明白了,大模型要落地,就得靠这些做知识工程和知识图谱的公司填坑。风口吹过之后,裸泳的都露出来了,真正解决问题的技术,早晚都会被重新发现。
## 结语
很多人喜欢追新,新技术出来就把老技术踩一脚,仿佛越新越好。但产业落地从来不是比谁新,是比谁能解决真问题。知识图谱不是过时的旧技术,是被大模型的光芒遮住的真需求,等热潮退了,你会发现它才是AI能落地的压舱石。 
