隐私计算:困在“可用不可见”里的产业新赌局
# 隐私计算:困在“可用不可见”里的产业新赌局
## 摘要
数据要素市场化的浪潮下,隐私计算从实验室冷门技术变成资本追逐的热点。本文拆解隐私计算的技术边界、产业现状与落地瓶颈,判断未来几年行业的真实走向。
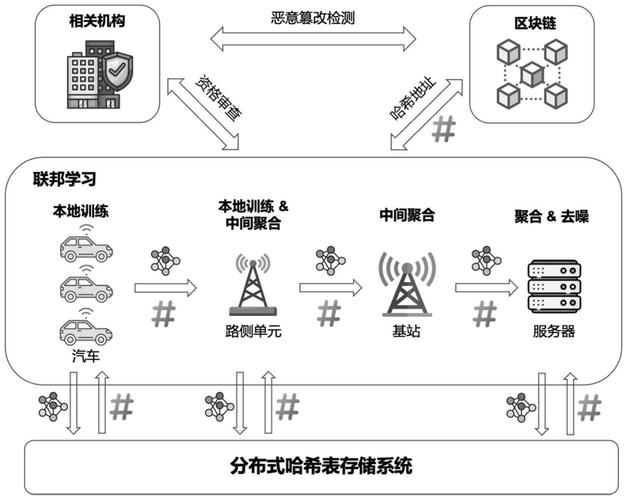 隐私计算联邦学习数据交互示意图
很多人被厂商宣传搞晕,以为隐私计算是某一种单一的黑科技。其实不是。现在主流的技术路线分三类,各干各的活:联邦学习适合跨机构联合建模,是目前落地最多的路线;安全多方计算理论上安全性最高,但是性能损耗大,大多只用在小数据量的敏感场景;差分隐私更多是给公开数据加噪声,用在数据发布环节。
说实话,没有哪一种技术能通吃所有场景。现在很多厂商喊自己“全栈隐私计算”,多半是为了拿项目凑出来的概念。性能损耗是从实验室出来就绕不开的老问题。同样的模型,原生跑一秒出结果,用上隐私计算可能要跑十几秒甚至几分钟,成本翻好几倍。不是所有场景都能承受这个代价。
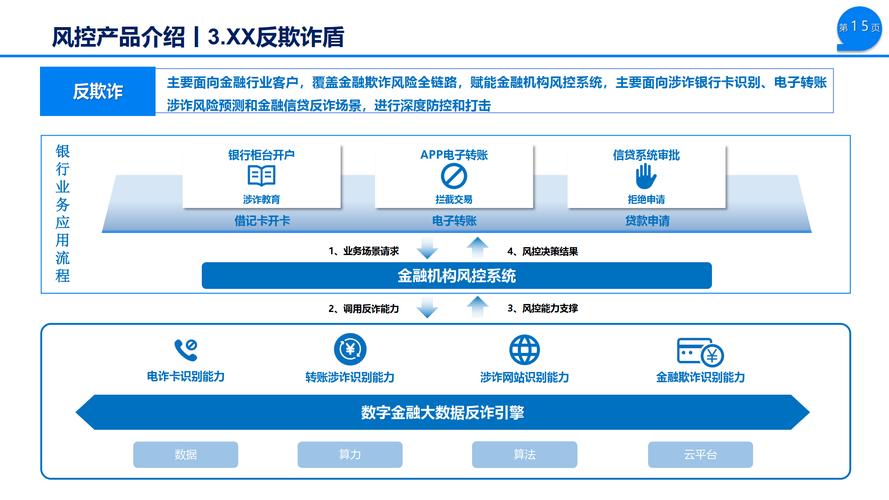 隐私计算金融风控联合建模应用场景图
现在行业里的玩家分三派:第一派是互联网大厂,百度、阿里、腾讯都有自己成熟的隐私计算平台,本身有场景有流量,自己用够了还能对外输出。第二派是传统IT和金融科技厂商,顺着风口转过来,靠自己积累的行业客户资源拿项目。第三派是专门的隐私计算创业公司,前两年融资热的时候,随便一个有博士团队的PPT就能融到大几千万,现在日子普遍不好过。
实话实说,百分之八十的项目现在都停留在试点阶段,停留在“建成了”“跑通了”的宣传阶段,真的大规模上线,真的靠隐私计算赚到钱的,没几家。很多机构搞隐私计算平台,就是为了符合监管要求摆着看的,不是真的要靠它挖数据价值。不过话说回来,也真有跑通的,头部股份制银行的跨机构联合风控,一年靠这个降低的坏账损失,远超过平台的投入,这就是真刚需,骗不了人。
 绕不开的天花板:不在技术,在规则
现在隐私计算遇到的瓶颈,大半都不是技术问题,是技术之外的问题。
首先,安全从来不是绝对的。很多厂商宣传隐私计算“100%不泄露”,这就是吹牛。这几年学术界已经有不少研究成果,通过侧信道攻击、梯度反推,就能从中间结果里还原出原始数据的部分信息。说白了,隐私计算只是降低了隐私泄露的风险,不是给数据上了保险箱。
其次,标准不互通。现在各家厂商的平台都是自己做的,接口、算法都不统一,A机构用甲家的平台,B机构用乙家的,两个人要合作联合建模,还要做一堆二次开发,成本直接涨上去,很多合作谈到这里就黄了。
还有最现实的利益分配问题。跨机构合作,你出数据我出技术他出算力,最后用隐私计算赚了钱,怎么分?现在没有成熟的分配机制,也没有明确的规则说,出多少数据拿多少收益,很多机构本来想合作,一算账谈不拢,就没下文了。
合规边界也模糊。现在监管要求数据“可用不可见”,但用了隐私计算就一定合规吗?出了问题算谁的责任?很多时候没有明确的说法,机构也不敢随便碰。
“可用不可见”,不是万能魔法
你肯定听过无数次,数据是新时代的石油。 可问题是,这桶油你不敢挖,挖了就是合规风险。各个机构手里攥着大把数据,想换钱想挖价值,就是不敢随便流出去,一不小心就触碰隐私红线。 隐私计算就是奔着这个问题来的。核心逻辑很简单:让数据能用,但是不能被看见。打个比方,两家银行要联合做反欺诈模型,原来要互换客户原始信息,这直接犯法。用上隐私计算,双方都不用把原始数据出自己的服务器,只传递建模过程中的中间加密结果,最后训出来的模型效果和用全量原始数据差不了多少,谁都没拿到对方的核心隐私。隐私计算联邦学习数据交互示意图
很多人被厂商宣传搞晕,以为隐私计算是某一种单一的黑科技。其实不是。现在主流的技术路线分三类,各干各的活:联邦学习适合跨机构联合建模,是目前落地最多的路线;安全多方计算理论上安全性最高,但是性能损耗大,大多只用在小数据量的敏感场景;差分隐私更多是给公开数据加噪声,用在数据发布环节。
说实话,没有哪一种技术能通吃所有场景。现在很多厂商喊自己“全栈隐私计算”,多半是为了拿项目凑出来的概念。性能损耗是从实验室出来就绕不开的老问题。同样的模型,原生跑一秒出结果,用上隐私计算可能要跑十几秒甚至几分钟,成本翻好几倍。不是所有场景都能承受这个代价。
落地的真相:试点多,赚钱的少
现在隐私计算的落地,基本集中在三个刚需领域:金融、政务、医疗。 金融是最成熟的。银行之间联合做风控、反欺诈,信用卡审批、信贷风控,你在A行有逾期记录,B行不知道,直接批卡就会增加坏账风险,原来不敢共享数据,隐私计算刚好解决这个问题。政务领域更不用说,各地建数据交易所,都要配隐私计算平台,不然数据根本没法进场交易。医疗领域,多家医院联合训练AI辅助诊断模型,患者隐私不能碰,隐私计算也能用上。隐私计算金融风控联合建模应用场景图
现在行业里的玩家分三派:第一派是互联网大厂,百度、阿里、腾讯都有自己成熟的隐私计算平台,本身有场景有流量,自己用够了还能对外输出。第二派是传统IT和金融科技厂商,顺着风口转过来,靠自己积累的行业客户资源拿项目。第三派是专门的隐私计算创业公司,前两年融资热的时候,随便一个有博士团队的PPT就能融到大几千万,现在日子普遍不好过。
实话实说,百分之八十的项目现在都停留在试点阶段,停留在“建成了”“跑通了”的宣传阶段,真的大规模上线,真的靠隐私计算赚到钱的,没几家。很多机构搞隐私计算平台,就是为了符合监管要求摆着看的,不是真的要靠它挖数据价值。不过话说回来,也真有跑通的,头部股份制银行的跨机构联合风控,一年靠这个降低的坏账损失,远超过平台的投入,这就是真刚需,骗不了人。
绕不开的天花板:不在技术,在规则
绕不开的天花板:不在技术,在规则
现在隐私计算遇到的瓶颈,大半都不是技术问题,是技术之外的问题。
首先,安全从来不是绝对的。很多厂商宣传隐私计算“100%不泄露”,这就是吹牛。这几年学术界已经有不少研究成果,通过侧信道攻击、梯度反推,就能从中间结果里还原出原始数据的部分信息。说白了,隐私计算只是降低了隐私泄露的风险,不是给数据上了保险箱。
其次,标准不互通。现在各家厂商的平台都是自己做的,接口、算法都不统一,A机构用甲家的平台,B机构用乙家的,两个人要合作联合建模,还要做一堆二次开发,成本直接涨上去,很多合作谈到这里就黄了。
还有最现实的利益分配问题。跨机构合作,你出数据我出技术他出算力,最后用隐私计算赚了钱,怎么分?现在没有成熟的分配机制,也没有明确的规则说,出多少数据拿多少收益,很多机构本来想合作,一算账谈不拢,就没下文了。
合规边界也模糊。现在监管要求数据“可用不可见”,但用了隐私计算就一定合规吗?出了问题算谁的责任?很多时候没有明确的说法,机构也不敢随便碰。

