自然语言处理:从“听懂人话”到改变产业的隐形革命
前阵子去国内一家头部AI厂商的开放日,亲眼撞见NLP团队的现场演示:把堆了半人高、扫描版的十年旧律师卷宗扔进去,不到四十分钟,系统自动梳理完了三起跨年度股权纠纷的所有争议焦点、证据链时间线,甚至标注出了原律师函里遗漏的法律条文。
当时整个场子都炸了。
很多人对自然语言处理的印象,还停留在ChatGPT聊天、智能客服答问题,其实它早就悄悄钻进了各个产业的骨头里,是这波AI革命里最赚钱、落地最广的分支。
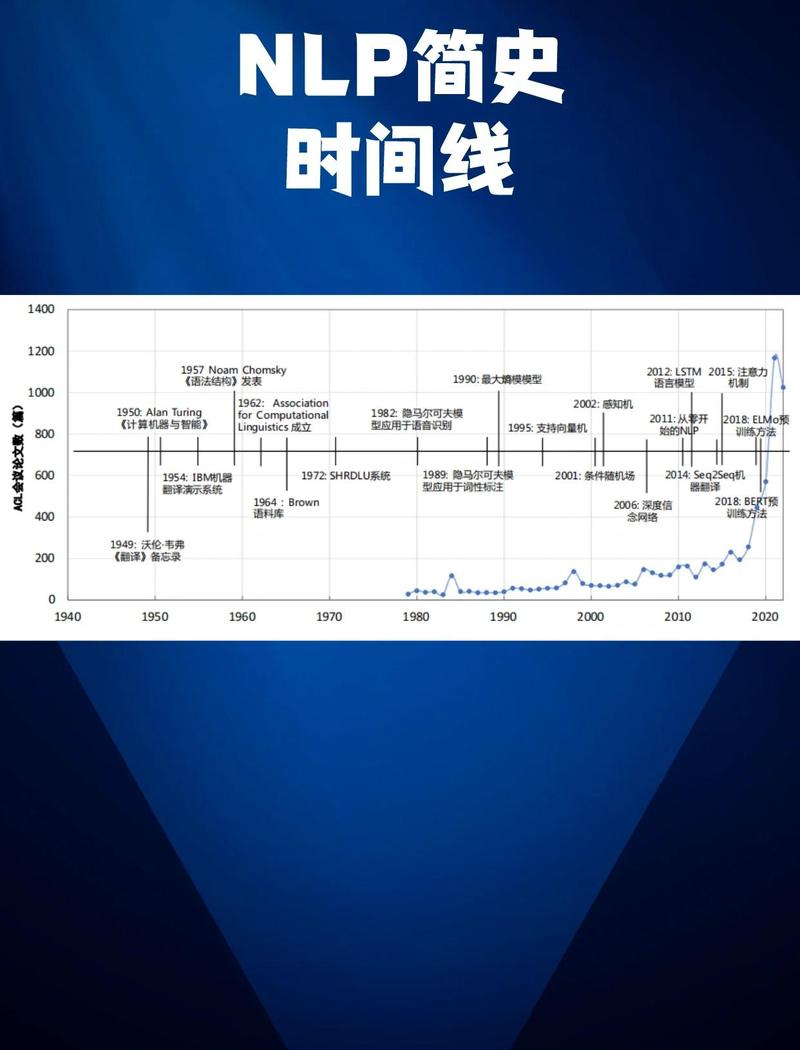 自然语言处理技术发展时间线
现在的大模型本质上,就是超大参数的自然语言处理模型。不过话说回来,技术依然有清晰的边界。
现在最先进的模型,依然搞不定那些低资源语种,国内几大方言里,除了粤语有足够语料,其他像温州话、闽南语的商用NLP模型,准确率连七成都不到。更别说人类语言里的潜台词,职场上说“你回去等通知”,机器能识别每个字,能读懂这是90%概率的婉拒吗?多数还做不到。对吧?
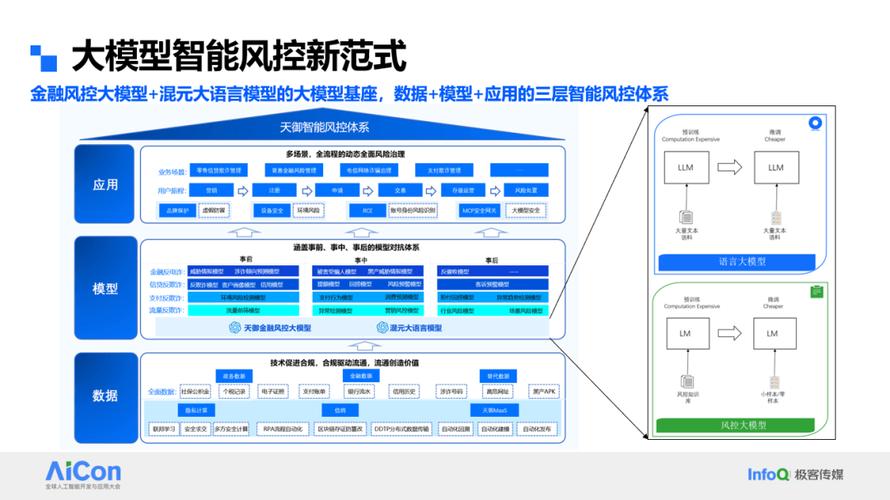 自然语言处理金融风控应用场景图
说实话,落地的障碍其实一直都在,不是技术不行,是成本和数据卡脖子。
中小企业想用适配自己业务的NLP模型,微调加部署,动辄几十万起,对小商家来说根本承受不起。还有数据隐私的问题,医疗行业要做NLP辅助诊断,需要大量病历语料,但病历是涉密的,不能拿出去训练模型,很多医院想做也做不了。这个坎,到现在还没人能完美解决。
 被忽略的风险,比假新闻更值得警惕
现在大家聊AI风险,都盯着深度伪造、假新闻,其实自然语言处理带来的很多风险,更隐蔽,也更棘手。
训练语料里自带的偏见,会被NLP模型成百上千倍放大。之前国外有公司做招聘筛选的NLP工具,训练语料用了过去十年的招聘数据,里面大部分高管都是男性,模型直接学会了看到女性求职者就自动打低分,相当于公然的就业歧视,直到用了一年多才被发现。
还有隐私问题。现在很多智能输入法、智能客服,都会把用户输入的文字、对话偷偷拿去训练模型,你输入的地址、病史、聊天内容,全变成了模型训练的数据,没人问过你同不同意。还有今年冒出来的AI诈骗,用NLP克隆你的声音、模仿你的说话语气,给你的家人发消息骗钱,已经有不少人上当了。
治理的速度,远远赶不上技术跑的速度。
垂直领域的轻量化NLP模型,会是接下来三年的产业主赛道。通用大模型聊天火,但大部分产业场景不需要那么大的参数,一个专门做法律文书整理的垂直小模型,准确率比GPT还高,成本只有十分之一,未来肯定会越来越吃香。
第二,端侧NLP会快速落地,以后不用把数据传到云端,手机、本地服务器就能跑NLP模型,隐私问题解决一大半,成本也降下来。
第三,监管一定会跟上,未来所有商用的NLP产品,都必须过偏见检测、语料合规审核,不合规的根本没法上线。
不过话说回来,不能因为有风险就否定技术的价值。自然语言处理做的事,本质上就是把人从无穷无尽的文字劳动里解放出来,不用天天抄文档、整理卷宗、筛简历,让人去干更需要创造力的事。
上个月和一个做了十年NLP的创业者吃饭,他说前八年公司连盈亏平衡都做不到,没人愿意投,最近两年出门谈业务,投资方追着问要不要加钱。哪有什么突然爆发的奇迹,都是攒了几十年的技术,刚好到了开花结果的时候罢了。
自然语言处理到底在解决什么核心问题
核心痛点从来不是“识别文字”,而是理解语言背后的歧义和意图。人类的语言太灵活了,同样一句“我明天过来拿”,换个场景、换个语气,意思完全不一样。就说“苹果真好吃”,是说水果还是手机?换做三十年前,机器根本搞不清。 早年的自然语言处理,走的是规则路线,语言学家一条条写语法规则,堆了几十年,还是搞不定日常对话的十分之一。后来统计机器学习起来,改成靠海量语料统计概率,才慢慢能用上。直到2017年Transformer论文出来,整个赛道才彻底变天。自然语言处理技术发展时间线
现在的大模型本质上,就是超大参数的自然语言处理模型。不过话说回来,技术依然有清晰的边界。
现在最先进的模型,依然搞不定那些低资源语种,国内几大方言里,除了粤语有足够语料,其他像温州话、闽南语的商用NLP模型,准确率连七成都不到。更别说人类语言里的潜台词,职场上说“你回去等通知”,机器能识别每个字,能读懂这是90%概率的婉拒吗?多数还做不到。对吧?
产业落地的真相,远不止聊天机器人这一种场景
很多人提起自然语言处理,第一反应就是做聊天机器人,其实这块赚钱的大头,早就沉到各个垂直产业里了。 金融行业是最早吃螃蟹的。券商研究员要整理上百份研报找投资逻辑,之前一个人要熬三个大夜,现在用NLP模型抽核心观点、拆数据,不到两小时就能做完。风控领域更狠,机构用NLP爬取全网公开的企业舆情、司法失信信息,自动标注风险等级,比人工风控快了上百倍,漏检率还降了近四成。 客服行业更不用说,国内头部的客服厂商,早就用NLP做坐席实时辅助了,客服接电话的时候,模型自动把客户问题、对应知识库答案弹在屏幕上,新人不用培训三个月就能上岗,整体人工成本降了快两成。自然语言处理金融风控应用场景图
说实话,落地的障碍其实一直都在,不是技术不行,是成本和数据卡脖子。
中小企业想用适配自己业务的NLP模型,微调加部署,动辄几十万起,对小商家来说根本承受不起。还有数据隐私的问题,医疗行业要做NLP辅助诊断,需要大量病历语料,但病历是涉密的,不能拿出去训练模型,很多医院想做也做不了。这个坎,到现在还没人能完美解决。
被忽略的风险,比假新闻更值得警惕
被忽略的风险,比假新闻更值得警惕
现在大家聊AI风险,都盯着深度伪造、假新闻,其实自然语言处理带来的很多风险,更隐蔽,也更棘手。
训练语料里自带的偏见,会被NLP模型成百上千倍放大。之前国外有公司做招聘筛选的NLP工具,训练语料用了过去十年的招聘数据,里面大部分高管都是男性,模型直接学会了看到女性求职者就自动打低分,相当于公然的就业歧视,直到用了一年多才被发现。
还有隐私问题。现在很多智能输入法、智能客服,都会把用户输入的文字、对话偷偷拿去训练模型,你输入的地址、病史、聊天内容,全变成了模型训练的数据,没人问过你同不同意。还有今年冒出来的AI诈骗,用NLP克隆你的声音、模仿你的说话语气,给你的家人发消息骗钱,已经有不少人上当了。
治理的速度,远远赶不上技术跑的速度。
垂直领域的轻量化NLP模型,会是接下来三年的产业主赛道。通用大模型聊天火,但大部分产业场景不需要那么大的参数,一个专门做法律文书整理的垂直小模型,准确率比GPT还高,成本只有十分之一,未来肯定会越来越吃香。
第二,端侧NLP会快速落地,以后不用把数据传到云端,手机、本地服务器就能跑NLP模型,隐私问题解决一大半,成本也降下来。
第三,监管一定会跟上,未来所有商用的NLP产品,都必须过偏见检测、语料合规审核,不合规的根本没法上线。
不过话说回来,不能因为有风险就否定技术的价值。自然语言处理做的事,本质上就是把人从无穷无尽的文字劳动里解放出来,不用天天抄文档、整理卷宗、筛简历,让人去干更需要创造力的事。
上个月和一个做了十年NLP的创业者吃饭,他说前八年公司连盈亏平衡都做不到,没人愿意投,最近两年出门谈业务,投资方追着问要不要加钱。哪有什么突然爆发的奇迹,都是攒了几十年的技术,刚好到了开花结果的时候罢了。 
