语音识别:我们高估了当下,却可能低估了未来
前几天打滴滴,司机师傅等红灯的时候发微信,全程用语音输入,我数了一下,12个字的消息,错了7个。那还是国内头部厂商做的输入法。你说神奇不?
我们天天听人说,语音识别已经成熟了,是下一代交互革命。真的吗?
 不同噪音环境下语音识别准确率对比图
说实话,现在卡脖子的地方根本不是基础算法,是极端场景的适配。远场拾音五米外说话,混着好几个不同方向的声音,模型根本分不清楚谁在说什么。国内上百种方言,小语种,能拿到的标注语料少得可怜,别说偏远地区的方言,就是广东西部的一些口音,现在识别准确率也不到八成。
更别说还有带口音的外国人说话,或者有语言障碍的用户发音,这些长尾需求,根本没人愿意花钱做语料标注,大模型再大也学不会。
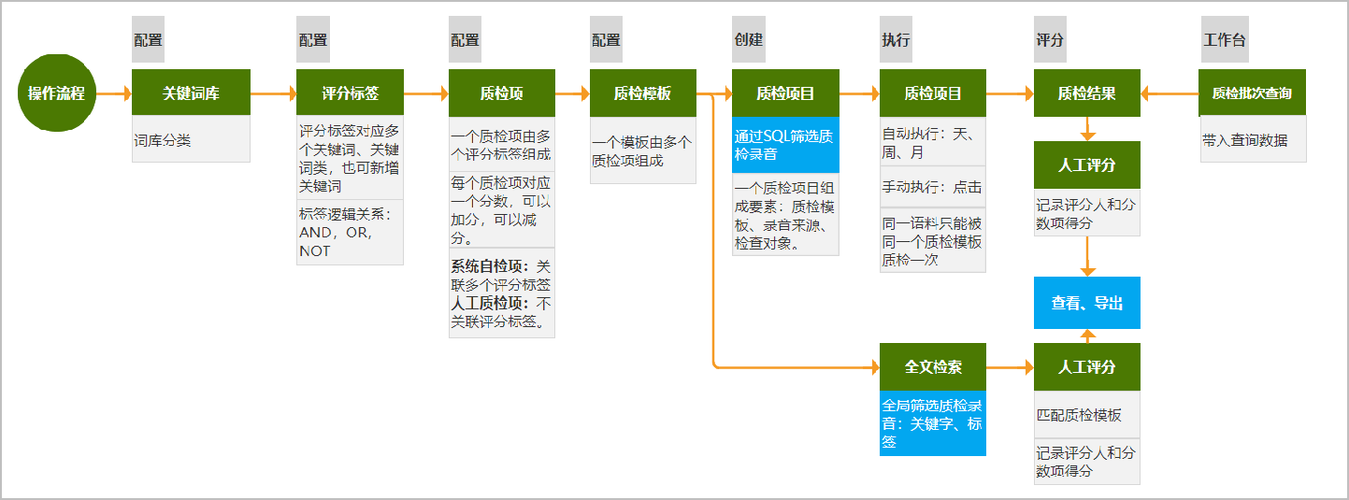 企业客服场景语音质检工作流程图
从整个产业格局看,上游的麦克风阵列硬件已经成熟,方案都标准化了,中游的通用算法市场早就杀成了红海,百度、科大讯飞、海外的OpenAI、谷歌几家占了九成以上的市场份额,小创业公司根本拿不到订单,活不下去。
真正的空白在下游垂直场景。比如汽车工厂的车间,噪音七八十分贝,工人要戴着手套操作设备,想用语音调用机床参数,现在能落地的稳定方案没几家,一套下来贵得离谱,中小工厂根本买不起。再比如医院的手术室,医生做手术的时候要口头记录病程,不能碰键盘,需要语音识别实时转写,还要识别专业医学术语,现在能用的方案也少得可怜。这些场景不是不需要,是技术还没到位,成本还没打下来。
 看不见的风险,比技术瓶颈更值得警惕
技术本身中性,但用的人不一样,问题就来了。
第一个是安全风险,现在语音生成技术已经能以假乱真,拿到你一分钟的录音,就能生成你任何内容的语音,骗子用你父母的声音找你要钱,普通人根本分不出来。更别说很多智能设备一直处于拾音状态,你在家说的每一句话,都可能被上传到厂商的服务器,哪怕厂商说不存储,谁能担保不会泄露?
第二个是职场异化,我去年接触过一个做电销的朋友,公司所有客服的通话全程被语音识别监控,只要说出规定外的词,哪怕是不小心带了一句口头禅,系统自动扣绩效。一天说够多少个关键词才算合格,全靠语音识别计数,工人变成了系统的节点,想想都喘不过气。
第三个是公平性问题,刚才说的,方言识别不准,语言障碍用户识别不准,等于把这些群体直接排除在了技术便利之外,明明是所有人用的技术,最后只便利了说标准普通话、身体正常的群体,这个问题,至今没多少人在意。
说实话,我接触过不少做语音识别的创业者,都喊着要替代键盘,做下一代交互入口。我看哪,还差得远。未来三到五年,通用语音识别的价格会跌到几乎免费,真正赚钱的是垂直领域的场景化调优,懂行业的玩家会吃到最大的蛋糕。语音和大模型结合之后,转完文字直接帮你总结要点生成回复,这个功能会快速普及,我们整理文档的时间会少很多。但语音永远不会完全替代打字,很多场景,安安静静打字,比开口说话方便多了,对吧?
我们高估了它当下能解决的问题,也别低估它未来十年能改变的东西。慢慢来,这技术还早着呢。
被神话的准确率,藏着没说的技术边界
现在主流的语音识别技术,走的是端到端大模型路线,说白了就是喂给模型几十万小时的标注语音,让模型自己学语音和文字的对应关系。这个路线比早年的声学模型语言模型分开跑,准确率确实提升了一大截。 但是厂商宣传的99%识别准确率,全是在消音室、标准普通话、单人声的测试集里跑出来的数字。出了实验室,楼下奶茶店点单,背景有空调声排号声,再带点地方口音,准确率直接掉去60%都不算夸张。不同噪音环境下语音识别准确率对比图
说实话,现在卡脖子的地方根本不是基础算法,是极端场景的适配。远场拾音五米外说话,混着好几个不同方向的声音,模型根本分不清楚谁在说什么。国内上百种方言,小语种,能拿到的标注语料少得可怜,别说偏远地区的方言,就是广东西部的一些口音,现在识别准确率也不到八成。
更别说还有带口音的外国人说话,或者有语言障碍的用户发音,这些长尾需求,根本没人愿意花钱做语料标注,大模型再大也学不会。
已经渗透的产业,远没到爆发的节点
你没感觉错,语音识别其实已经偷偷渗进了我们生活的每个角落。输入法的语音输入,智能电视的语音搜片,车机的语音开空调,开会自动出纪要,客服通话自动质检,这些都是已经落地的应用。 不过话说回来,绝大多数应用都还停留在"能用,但不好用"的阶段。我开会常用自动转写,三个人开会,两个人同时插嘴抢话,转写出来就是一团乱麻,全是重叠的文字,我要改半个钟头,比自己从头整理还费时间。企业客服场景语音质检工作流程图
从整个产业格局看,上游的麦克风阵列硬件已经成熟,方案都标准化了,中游的通用算法市场早就杀成了红海,百度、科大讯飞、海外的OpenAI、谷歌几家占了九成以上的市场份额,小创业公司根本拿不到订单,活不下去。
真正的空白在下游垂直场景。比如汽车工厂的车间,噪音七八十分贝,工人要戴着手套操作设备,想用语音调用机床参数,现在能落地的稳定方案没几家,一套下来贵得离谱,中小工厂根本买不起。再比如医院的手术室,医生做手术的时候要口头记录病程,不能碰键盘,需要语音识别实时转写,还要识别专业医学术语,现在能用的方案也少得可怜。这些场景不是不需要,是技术还没到位,成本还没打下来。
看不见的风险,比技术瓶颈更值得警惕
看不见的风险,比技术瓶颈更值得警惕
技术本身中性,但用的人不一样,问题就来了。
第一个是安全风险,现在语音生成技术已经能以假乱真,拿到你一分钟的录音,就能生成你任何内容的语音,骗子用你父母的声音找你要钱,普通人根本分不出来。更别说很多智能设备一直处于拾音状态,你在家说的每一句话,都可能被上传到厂商的服务器,哪怕厂商说不存储,谁能担保不会泄露?
第二个是职场异化,我去年接触过一个做电销的朋友,公司所有客服的通话全程被语音识别监控,只要说出规定外的词,哪怕是不小心带了一句口头禅,系统自动扣绩效。一天说够多少个关键词才算合格,全靠语音识别计数,工人变成了系统的节点,想想都喘不过气。
第三个是公平性问题,刚才说的,方言识别不准,语言障碍用户识别不准,等于把这些群体直接排除在了技术便利之外,明明是所有人用的技术,最后只便利了说标准普通话、身体正常的群体,这个问题,至今没多少人在意。
说实话,我接触过不少做语音识别的创业者,都喊着要替代键盘,做下一代交互入口。我看哪,还差得远。未来三到五年,通用语音识别的价格会跌到几乎免费,真正赚钱的是垂直领域的场景化调优,懂行业的玩家会吃到最大的蛋糕。语音和大模型结合之后,转完文字直接帮你总结要点生成回复,这个功能会快速普及,我们整理文档的时间会少很多。但语音永远不会完全替代打字,很多场景,安安静静打字,比开口说话方便多了,对吧?
我们高估了它当下能解决的问题,也别低估它未来十年能改变的东西。慢慢来,这技术还早着呢。 
