知识图谱:被大模型掩盖的AI基础设施,正在悄悄重构产业逻辑
去年跟某大厂AI部门的负责人喝咖啡。
他翻着手机里的一周融资新闻笑。“现在出门说自己做知识图谱,都不好意思开口,全改头换面做大模型应用了”。
说实话,这两年大模型的风头太盛,知识图谱好像硬生生被打成了“上个时代的落后技术”。投资圈不看好,创业圈换赛道,连很多高校的实验室都把方向转去微调大模型了。
但真相是,知识图谱从来没走,它只是藏到大模型的光环背后,成了当前AI落地最离不开的隐形骨架。
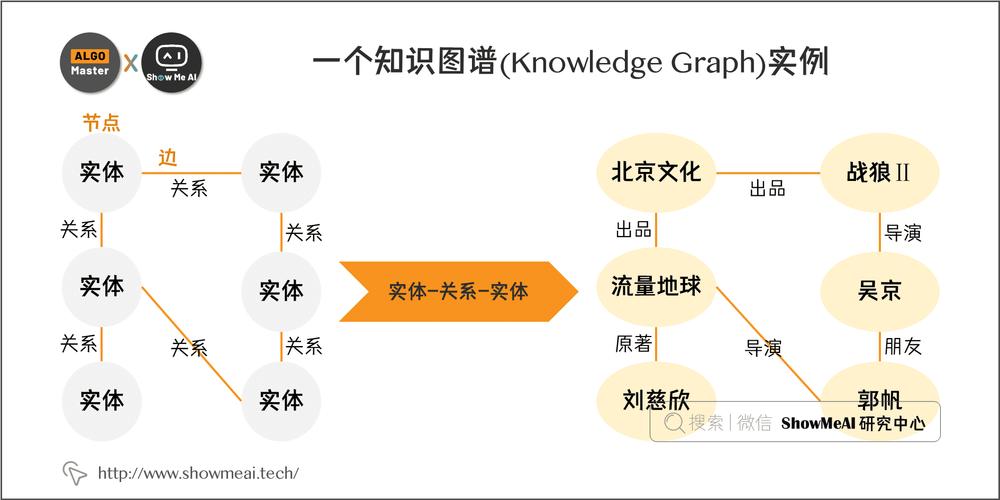 通用领域知识图谱实体关系示意图
说白了,两者从诞生起就是互补的,不是替代关系。知识图谱能解决大模型天生的缺陷——幻觉问题,而大模型能解决知识图谱过去最大的痛点:自动构建成本太高。过去做一个领域知识图谱,要请大量行业专家手动标注,一两年出不来能用的东西,现在大模型可以自动抽取实体和关系,标注成本直接降了八成以上。
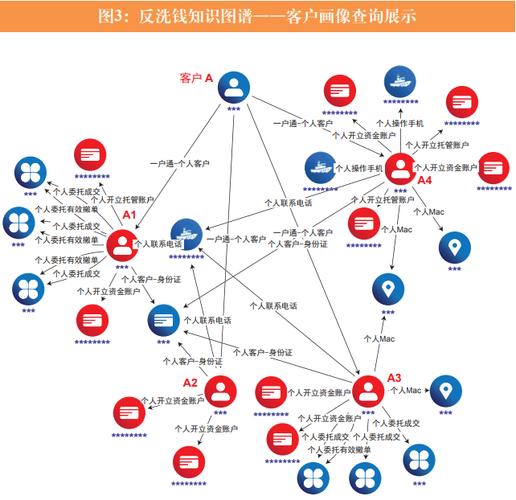 金融反欺诈知识图谱企业关联关系网络图
不过话说回来,哪怕是落地好的场景,也绕不开现存的问题。最大的问题就是数据隐私和知识版权。做知识图谱要爬大量公开数据,很多内容的版权归属说不清楚,一不小心就吃官司。要是做面向个人的知识图谱,比如把你的社交、消费、出行数据整合起来做个性化推荐,那隐私风险更大,一旦泄露就是灭顶之灾。还有一个问题是标准不统一,不同企业做的领域知识图谱,实体和关系的定义不一样,根本没法互通,重复造轮子的情况太普遍。
 未来三年:知识图谱会重新回到舞台中央
现在业内已经有越来越多人意识到,纯大模型落不了地,To B的产业AI更是如此。企业要的不是能侃大山的聊天机器人,要的是能准确输出业务知识、不出错的AI助手,而能把大模型的能力框在正确范围里的,就是知识图谱。
现在火得一塌糊涂的检索增强生成(RAG),本质就是把知识图谱作为结构化知识库,给大模型提供准确的参考来源,从根源上减少幻觉。我接触到的几个大模型创业公司,今年都在悄悄补知识图谱的课,原来只靠大模型做客服,出错率超过10%,加了垂直领域知识图谱之后,出错率降到1%以下,客户一下就买单了。
未来三到五年,我判断产业AI的主流形态一定是“知识图谱+大模型”的融合。知识图谱做确定性的骨架,负责存储、推理和管控业务知识,大模型做柔性的能力,负责理解、生成和交互,两者各干各擅长的事。
不会有谁取代谁。那些喊着知识图谱已死的人,要么是不懂行,要么就是想蹭大模型的热度割韭菜。
你看今年开的几次AI产业大会,知识图谱的分论坛反而比前两年更热闹了,参会的全是实体产业的人,他们不搞概念,只找能解决问题的技术。
说白了,技术从来不是追风口,能解决真问题的,永远不会被淘汰。
技术边界:它从来不是大模型的对手,是底座
很多人对知识图谱的误解,从一开始就错了。 有人说知识图谱就是把知识点存在库里,跟传统数据库没区别。不对。 知识图谱的核心,是用网状结构存储实体、实体属性以及实体之间的关系。比如“刘德华”是一个实体,“出生于1961年”是属性,“参演了《无间道》”是他和《无间道》这个实体的关系。这种结构化的表达,完全符合人类认知世界的逻辑。 对比一下大模型,大模型是靠概率猜下一个字,知识图谱是明确告诉你“谁和谁是什么关系”。一个是黑箱的概率生成,一个是白箱的确定性表达。通用领域知识图谱实体关系示意图
说白了,两者从诞生起就是互补的,不是替代关系。知识图谱能解决大模型天生的缺陷——幻觉问题,而大模型能解决知识图谱过去最大的痛点:自动构建成本太高。过去做一个领域知识图谱,要请大量行业专家手动标注,一两年出不来能用的东西,现在大模型可以自动抽取实体和关系,标注成本直接降了八成以上。
产业落地的真坑:很多人从第一步就走错了
知识图谱发展快二十年了,为什么真正大规模落地的场景其实不算多? 我接触过不下十个传统企业的知识图谱项目,十个里有七个烂尾了。问题出在哪? 大部分企业刚接触知识图谱,上来就喊着要做“全行业全场景的企业知识大图谱”,要把公司几十年攒的产品文档、技术资料、客户数据全都结构化进去,预算砸了几千万,做了一年多发现,知识永远补不全,今天改了一个产品参数,明天又出了新的品类,更新维护的成本比构建成本还高,最后只能放在服务器落灰。 现在活得好的知识图谱项目,全都是切小场景、解决具体问题的。 比如金融行业的反欺诈,骗贷的人最喜欢用空壳公司层层嵌套,人工查关联要查半个月,知识图谱把所有企业法人、股东、出资方的关系一拉,关联交易、循环出资一眼就能看出来,现在国内主流银行的反欺诈系统,核心就是知识图谱。 还有电商的商品知识图谱,你搜“轻薄笔记本2024款”,平台能精准给你匹配符合你要求的所有商品,还能给你推适配的鼠标、拓展坞,靠的就是知识图谱对商品属性的结构化梳理,大模型裸跑根本做不到这么精准。金融反欺诈知识图谱企业关联关系网络图
不过话说回来,哪怕是落地好的场景,也绕不开现存的问题。最大的问题就是数据隐私和知识版权。做知识图谱要爬大量公开数据,很多内容的版权归属说不清楚,一不小心就吃官司。要是做面向个人的知识图谱,比如把你的社交、消费、出行数据整合起来做个性化推荐,那隐私风险更大,一旦泄露就是灭顶之灾。还有一个问题是标准不统一,不同企业做的领域知识图谱,实体和关系的定义不一样,根本没法互通,重复造轮子的情况太普遍。
未来三年:知识图谱会重新回到舞台中央
未来三年:知识图谱会重新回到舞台中央
现在业内已经有越来越多人意识到,纯大模型落不了地,To B的产业AI更是如此。企业要的不是能侃大山的聊天机器人,要的是能准确输出业务知识、不出错的AI助手,而能把大模型的能力框在正确范围里的,就是知识图谱。
现在火得一塌糊涂的检索增强生成(RAG),本质就是把知识图谱作为结构化知识库,给大模型提供准确的参考来源,从根源上减少幻觉。我接触到的几个大模型创业公司,今年都在悄悄补知识图谱的课,原来只靠大模型做客服,出错率超过10%,加了垂直领域知识图谱之后,出错率降到1%以下,客户一下就买单了。
未来三到五年,我判断产业AI的主流形态一定是“知识图谱+大模型”的融合。知识图谱做确定性的骨架,负责存储、推理和管控业务知识,大模型做柔性的能力,负责理解、生成和交互,两者各干各擅长的事。
不会有谁取代谁。那些喊着知识图谱已死的人,要么是不懂行,要么就是想蹭大模型的热度割韭菜。
你看今年开的几次AI产业大会,知识图谱的分论坛反而比前两年更热闹了,参会的全是实体产业的人,他们不搞概念,只找能解决问题的技术。
说白了,技术从来不是追风口,能解决真问题的,永远不会被淘汰。 
