自然语言处理:离真正的“懂语言”还有多远?
去年帮一个创业朋友改BP,他拍胸脯说自己做的NLP客服机器人能承接90%的售后问题,不用养那么多人工客服。结果上线三个月,80%的用户提问还是得转人工。他挠头说,模型训练的时候准确率92%,怎么到真实场景就拉胯?
相信我,这不是个例。现在打开创投圈的项目库,十个AI项目七个沾NLP,好像ChatGPT出来之后,自然语言处理已经无所不能了。真不是这么回事。
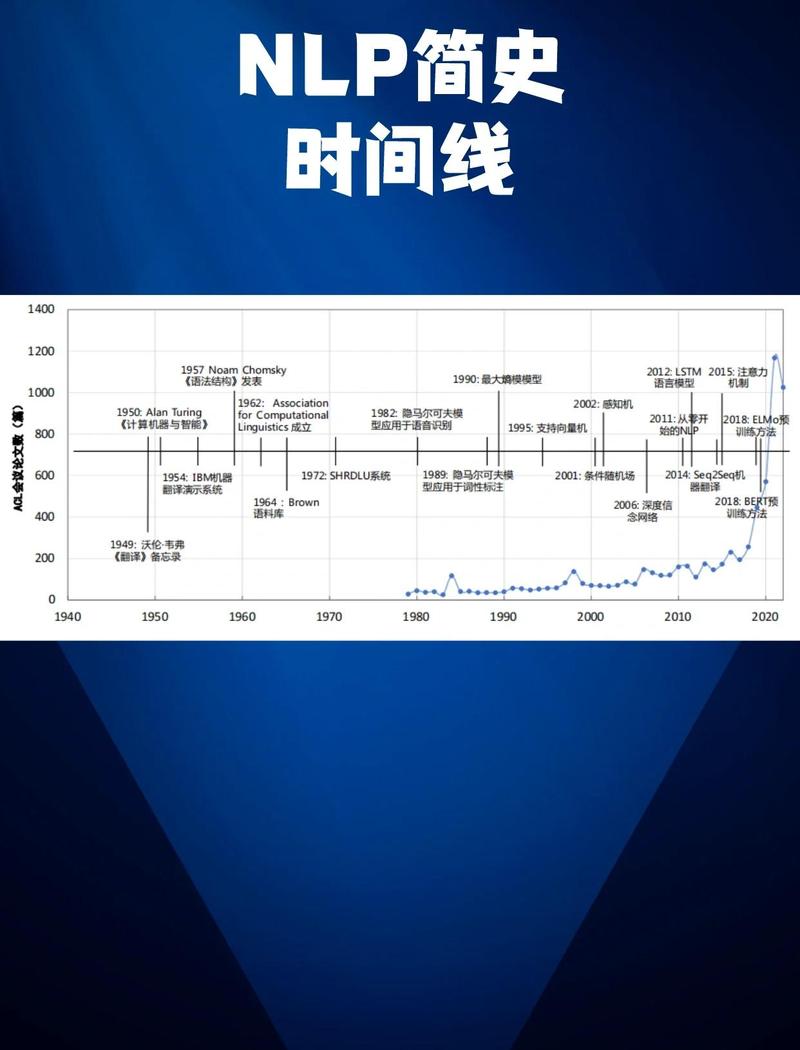 自然语言处理技术发展时间线
很多人以为现在大模型能写论文能写代码,就是真的懂语言了。不对。本质就是猜下一个字。它靠海量数据训练出来的概率分布,拼接出符合语法语义的句子,但是它真的不理解这句话背后的情绪、语境还有潜台词。
举个最简单的例子,你说“这顿饭吃的真好,就是太咸了”,模型能懂是说菜咸,但是如果是北方人冬天说“这天真热,得穿一件外套”,南方人可能都反应过来是反话,模型碰到这种小众语境的反讽,错的概率能超过一半。
现在的技术边界很清晰:通用、公开、标准化的自然语言处理,大模型已经做的足够好,甚至超过普通人。但是涉及到私人语境、行业黑话、模糊情绪的内容,机器还差的远。
 自然语言处理智能客服日常应用场景
不过话说回来,大部分NLP项目现在还是停留在PPT阶段,伪落地居多。我接触过一家做医疗NLP的创业公司,拿了天使轮,说能从电子病历里自动提取病史,准确率做到90%。结果到三甲医院落地,一跑准确率直接掉到58%。为什么?训练用的标注数据都是整理好的标准病历,真实的电子病历里,医生有自己的缩写习惯,还有各种手写转写的错字,同一个病好几种叫法,模型根本没见过,直接懵了。
现在产业化最大的两个障碍,一个是定制化成本太高,一个是数据安全。要做行业NLP,就得拿行业的专有数据标注,一家银行的法务NLP,光标注过往合同就要花几百万,效果还不一定比三个十年老法务好,中小客户根本用不起。就算你愿意掏钱,很多行业的数据不能外流,金融、医疗、政务,谁敢把核心数据传到第三方的大模型上?API调用都不敢。
OpenAI把NLP的底座做起来了,但是落地最后一公里的坑,到现在还没人能填上。
 未来三年:NLP的下半场怎么走
现在大家都在说NLP的风险,深度伪造换脸还要NLP生成语音和对话,现在能做到以假乱真,随便生成一段老板的聊天记录就能骗财务打款,这种诈骗案例今年已经出了不少。还有版权问题,大模型训练用的海量文字作品,大部分都没拿到授权,欧美已经打了好几个集体诉讼,国内的版权争议也只是没爆发而已。治理跟不上技术的速度,这是现在绕不开的问题。
未来三到五年,我看好两个方向,也敢说一个判断。
第一个方向是垂直领域小参数NLP。通用大模型已经卷到头了,接下来就是往下沉,给每个行业做定制化的小模型,参数不用那么大,只训练本行业的数据,成本降下来,准确率升上去,比如给出版社做的文字校对,给律所做的合同审查,都是刚需,现在已经有不少团队跑出来了。
第二个方向是多模态里的NLP升级。现在AI都在做图文视频多模态,但是不管是什么模态,要理解人类的需求,核心还是自然语言。你给AI发一张图配一句话,让它给你改图,核心是AI能不能读懂你那句话到底要什么,这对NLP的语义理解要求更高。
至于那个判断:别信什么NLP已经实现通用智能的鬼话,至少未来十年,NLP都做不到真正理解人类的语言。人类的语言本身就是自带模糊性的,话里有话,言外之意,有时候自己都搞不清楚自己要表达什么,何况机器。
但是这不代表NLP没用。哪怕它只能帮你干80%的重复劳动,剩下20%留给人,效率就能翻好几倍。原来一个编辑一天校一万字,现在NLP帮你干掉80%的错字语病,编辑只需要审内容,产出直接翻三倍,这就是实实在在的产业价值。
别被天上掉馅饼的概念吹晕了,自然语言处理还在青春期,路才走了一半。
NLP到底在解决什么问题?技术边界在哪
从最早的关键词匹配,到后来的统计机器学习,再到现在预训练大模型主导,NLP的核心目标从来没变过:让机器能听懂、看懂人类的自然语言,还能生成符合人类习惯的语言输出。自然语言处理技术发展时间线
很多人以为现在大模型能写论文能写代码,就是真的懂语言了。不对。本质就是猜下一个字。它靠海量数据训练出来的概率分布,拼接出符合语法语义的句子,但是它真的不理解这句话背后的情绪、语境还有潜台词。
举个最简单的例子,你说“这顿饭吃的真好,就是太咸了”,模型能懂是说菜咸,但是如果是北方人冬天说“这天真热,得穿一件外套”,南方人可能都反应过来是反话,模型碰到这种小众语境的反讽,错的概率能超过一半。
现在的技术边界很清晰:通用、公开、标准化的自然语言处理,大模型已经做的足够好,甚至超过普通人。但是涉及到私人语境、行业黑话、模糊情绪的内容,机器还差的远。
产业化落地:聚光灯外的真坑
现在NLP落地最成熟的场景,大家其实天天接触,只是没注意。内容审核就是最大的一块,国内几大内容平台,80%以上的违规内容都是NLP先拦下来,人工只需要复核存疑的内容,直接把原来几万人工审核的规模降了三分之一还多。还有智能输入法的联想,邮箱的自动分类,这些都是NLP用了很多年的成熟场景。自然语言处理智能客服日常应用场景
不过话说回来,大部分NLP项目现在还是停留在PPT阶段,伪落地居多。我接触过一家做医疗NLP的创业公司,拿了天使轮,说能从电子病历里自动提取病史,准确率做到90%。结果到三甲医院落地,一跑准确率直接掉到58%。为什么?训练用的标注数据都是整理好的标准病历,真实的电子病历里,医生有自己的缩写习惯,还有各种手写转写的错字,同一个病好几种叫法,模型根本没见过,直接懵了。
现在产业化最大的两个障碍,一个是定制化成本太高,一个是数据安全。要做行业NLP,就得拿行业的专有数据标注,一家银行的法务NLP,光标注过往合同就要花几百万,效果还不一定比三个十年老法务好,中小客户根本用不起。就算你愿意掏钱,很多行业的数据不能外流,金融、医疗、政务,谁敢把核心数据传到第三方的大模型上?API调用都不敢。
OpenAI把NLP的底座做起来了,但是落地最后一公里的坑,到现在还没人能填上。
未来三年:NLP的下半场怎么走
未来三年:NLP的下半场怎么走
现在大家都在说NLP的风险,深度伪造换脸还要NLP生成语音和对话,现在能做到以假乱真,随便生成一段老板的聊天记录就能骗财务打款,这种诈骗案例今年已经出了不少。还有版权问题,大模型训练用的海量文字作品,大部分都没拿到授权,欧美已经打了好几个集体诉讼,国内的版权争议也只是没爆发而已。治理跟不上技术的速度,这是现在绕不开的问题。
未来三到五年,我看好两个方向,也敢说一个判断。
第一个方向是垂直领域小参数NLP。通用大模型已经卷到头了,接下来就是往下沉,给每个行业做定制化的小模型,参数不用那么大,只训练本行业的数据,成本降下来,准确率升上去,比如给出版社做的文字校对,给律所做的合同审查,都是刚需,现在已经有不少团队跑出来了。
第二个方向是多模态里的NLP升级。现在AI都在做图文视频多模态,但是不管是什么模态,要理解人类的需求,核心还是自然语言。你给AI发一张图配一句话,让它给你改图,核心是AI能不能读懂你那句话到底要什么,这对NLP的语义理解要求更高。
至于那个判断:别信什么NLP已经实现通用智能的鬼话,至少未来十年,NLP都做不到真正理解人类的语言。人类的语言本身就是自带模糊性的,话里有话,言外之意,有时候自己都搞不清楚自己要表达什么,何况机器。
但是这不代表NLP没用。哪怕它只能帮你干80%的重复劳动,剩下20%留给人,效率就能翻好几倍。原来一个编辑一天校一万字,现在NLP帮你干掉80%的错字语病,编辑只需要审内容,产出直接翻三倍,这就是实实在在的产业价值。
别被天上掉馅饼的概念吹晕了,自然语言处理还在青春期,路才走了一半。 
