多模态大模型:被吹上天的风口,距离落地还有几道坎?
上个月跟一个AI创业团队创始人喝咖啡,他掏出手机给我演示自家的产品,我确实愣了两秒。
对着桌面乱拍一张,既有皱巴巴的合同、贴了便签的发票,还有我随手扔在边上的行程单,大模型十秒不到,就把合同核心条款、待付款金额、下周要开的项目会,全梳理成了可执行的项目排期表。
换去年,这种效果我想都不敢想。
 多模态大模型语义空间对齐示意图
这两年技术进展确实快,从OpenAI的GPT-4V,到国内几个头部厂商的多模态版本,已经能做到比较流畅的跨模态推理了。但技术边界其实很清晰:它能做关联理解,做不了因果推理。比如你给它看一张车撞树的照片,它能说出来“车撞了树,车头坏了”,但你问它“为什么会撞”,它大概率会瞎编,因为它没有那个把现场痕迹、环境因素、驾驶行为串起来推因果的能力。
 车载多模态大模型座舱交互演示
还有一个隐性的坑,就是适配成本。不同行业的多模态输入差异太大,医疗场景要懂DICOM影像的格式,工业场景要对接各种传感器的原始数据,不像纯文本大模型套个prompt就能用,每个项目都要重新改底层,项目交付周期比原来长一倍,根本赚不到规模效应的钱。
 未来三年,泡沫之后剩下什么
现在整个圈子都在喊多模态是通用人工智能的入口,我觉得这话吹得有点过。风险摆在这里,不说技术,伦理风险就够头疼:多模态能生成以假乱真的深度伪造视频、音频,现在的检测技术准确率不到七成,普通人根本分不出真假,要是被用来做谣言、诈骗,破坏力比原来的单模态生成大太多。
监管的靴子迟早会落地,未来多模态生成内容强制加水印、做溯源,肯定是板上钉钉的事,现在不少头部厂商已经偷偷在做这块的技术储备了。
说说我对未来三到五年的判断:
第一,通用多模态不会面向C端大规模落地,垂直领域的细分多模态会先跑出来。比如结合影像和病历的医疗辅助诊断、结合多传感器数据的工业故障预警、结合直播画面和弹幕的内容运营,这些场景有明确的付费需求,不需要模型有多通用,把一件事做好就能赚钱。
第二,底层基础设施会出来新的机会。现在所有人都抢着做上层应用,没人愿意啃多模态数据标注、推理加速、格式适配的硬骨头,未来一年,专门做这块服务的公司会起来,反而会比应用公司活得更稳。
第三,现在的估值泡沫会在18个月内破掉,至少七成蹭风口的多模态创业公司会死掉。很多团队就是把原来做图像识别、语音识别的业务换了个“多模态大模型”的皮,就出来涨估值,等资本退潮,裸泳的都会露出来。
说实话,我从来不否认多模态大模型的革命性。它是第一个让AI能像人一样,同时处理看得到、听得见、读得懂的信息的技术方向,这一步确实是跨越性的。只不过现在市场太狂热,把十年才能做成的事,吹成了明年就能落地赚钱的风口。
潮水退了,真能沉下心啃硬骨头的,才能最后拿到船票。对吧?
真多模态不是拼出来的拼盘
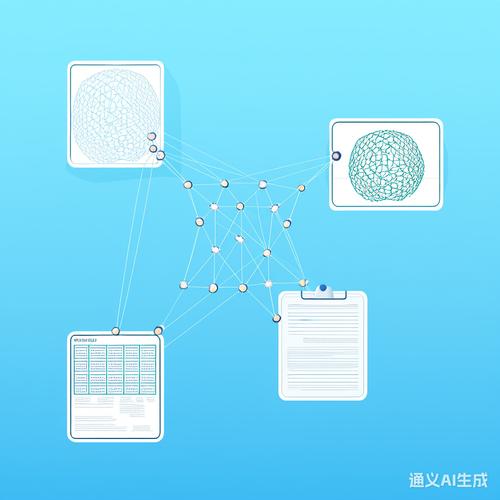
现在打开创投圈的BP,十个AI项目八个说自己做多模态,可九成以上都是“伪多模态”。说白了就是把训练好的文本大模型、图像大模型、语音模型拼在一块,中间加个转换层,遇到什么输入就丢给对应的模块处理,最后拼个结果出来。 真正的多模态大模型,核心是跨模态语义空间对齐。就是文字里的“蓝色金属划痕”,能和图像里那一块浅蓝色的瑕疵、还有传感器检测到的表面粗糙度数据,映射到同一个语义节点上,不需要转来转去,模型本身就能直接理解不同类型信息的关联。多模态大模型语义空间对齐示意图
这两年技术进展确实快,从OpenAI的GPT-4V,到国内几个头部厂商的多模态版本,已经能做到比较流畅的跨模态推理了。但技术边界其实很清晰:它能做关联理解,做不了因果推理。比如你给它看一张车撞树的照片,它能说出来“车撞了树,车头坏了”,但你问它“为什么会撞”,它大概率会瞎编,因为它没有那个把现场痕迹、环境因素、驾驶行为串起来推因果的能力。
落地的坑,一半在钱一半在技术
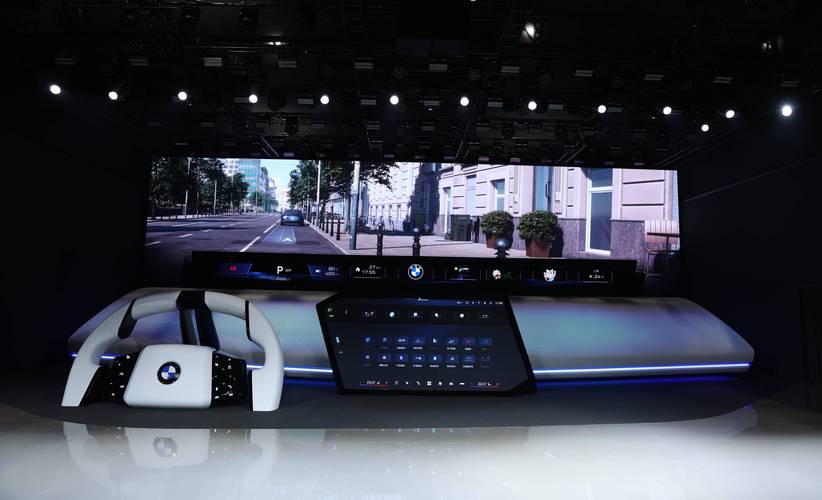
现在多模态的融资热,已经热得烫手了。但真落地到产业里,能跑通赚钱的项目,十个里挑不出一个。 我接触过一个给制造业做多模态质检的团队,demo拿出来效果特别好:同时看工业摄像头拍的表面图像、超声波传感器的内部检测数据、还有设备的运行噪音,能把原来人工漏检率降30%。结果落到工厂生产线,直接卡壳了。 为什么?第一个坑是数据。工厂里不同生产线的产品不一样,缺陷的形态千奇百怪,要攒够高质量的对齐多模态标注数据,成本是纯文本数据的15倍还多,一条生产线的标注费就能烧掉小一百万。中小企业买不起,大厂宁愿自己攒数据,这个生意很难做。 第二个坑是推理成本。同样参数规模,多模态大模型的单次推理成本,是纯文本大模型的3到4倍。我见过某头部车企的座舱多模态方案,要同时识别驾驶员表情、语音指令、前方路况,跑起来车机芯片直接冲上72度,夏天开空调都压不住温度,根本没法量产。车载多模态大模型座舱交互演示
还有一个隐性的坑,就是适配成本。不同行业的多模态输入差异太大,医疗场景要懂DICOM影像的格式,工业场景要对接各种传感器的原始数据,不像纯文本大模型套个prompt就能用,每个项目都要重新改底层,项目交付周期比原来长一倍,根本赚不到规模效应的钱。
未来三年,泡沫之后剩下什么
未来三年,泡沫之后剩下什么
现在整个圈子都在喊多模态是通用人工智能的入口,我觉得这话吹得有点过。风险摆在这里,不说技术,伦理风险就够头疼:多模态能生成以假乱真的深度伪造视频、音频,现在的检测技术准确率不到七成,普通人根本分不出真假,要是被用来做谣言、诈骗,破坏力比原来的单模态生成大太多。
监管的靴子迟早会落地,未来多模态生成内容强制加水印、做溯源,肯定是板上钉钉的事,现在不少头部厂商已经偷偷在做这块的技术储备了。
说说我对未来三到五年的判断:
第一,通用多模态不会面向C端大规模落地,垂直领域的细分多模态会先跑出来。比如结合影像和病历的医疗辅助诊断、结合多传感器数据的工业故障预警、结合直播画面和弹幕的内容运营,这些场景有明确的付费需求,不需要模型有多通用,把一件事做好就能赚钱。
第二,底层基础设施会出来新的机会。现在所有人都抢着做上层应用,没人愿意啃多模态数据标注、推理加速、格式适配的硬骨头,未来一年,专门做这块服务的公司会起来,反而会比应用公司活得更稳。
第三,现在的估值泡沫会在18个月内破掉,至少七成蹭风口的多模态创业公司会死掉。很多团队就是把原来做图像识别、语音识别的业务换了个“多模态大模型”的皮,就出来涨估值,等资本退潮,裸泳的都会露出来。
说实话,我从来不否认多模态大模型的革命性。它是第一个让AI能像人一样,同时处理看得到、听得见、读得懂的信息的技术方向,这一步确实是跨越性的。只不过现在市场太狂热,把十年才能做成的事,吹成了明年就能落地赚钱的风口。
潮水退了,真能沉下心啃硬骨头的,才能最后拿到船票。对吧? 
