大语言模型:不是万能魔法,却正在重塑科技产业
剥开概念:大语言模型的核心到底是什么
很多科普文章把它吹得玄乎,又是通用人工智能又是意识萌芽。说白了,核心逻辑简单到离谱——就是下一个词预测,英文叫Next Token Prediction。
你输入一段文字,它从训练过的几十上万亿token里,算出来哪个词出现在这里的概率最高,一个接一个拼出来给你。
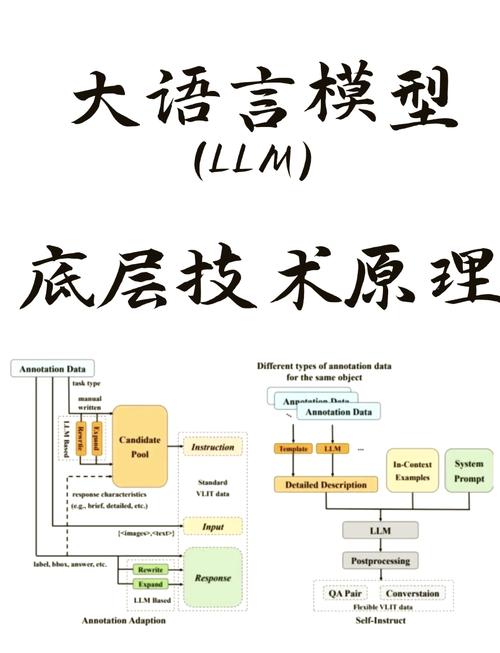 大语言模型next token预测流程示意图
就是这么简单的逻辑,撑起了现在所有的大模型应用。
那它的技术边界在哪里?说穿了也很残酷:它不会真正的逻辑推理,不会产生真实的思考,所有输出本质都是训练数据的概率重组。你让它写一篇1000字的散文,它能写得比大多数大学生还好。你让它算一道多位数乘法,它能给你算出好几个不同的错答案——因为它不是在算,是在“猜”下一个数字该是什么。
实话讲,这不是什么缺陷,是它的本质决定的。我们现在对大模型的很多误解,都来自把它的能力夸大了。
落地现状:一半是狂欢,一半是尴尬
现在公开说自己做大语言模型的公司,没有一百也有几十。从互联网大厂到创业公司,都在挤这条赛道。可真的落地赚到钱的,掰着手指头就能数过来。
第一类是To C的订阅服务,比如ChatGPT Plus,国内头部几家大模型的付费会员,加起来怎么也有大几百万付费用户了。一年收个十几亿会员费,这是真金白银。但问题也很明显,用户留存越来越低,很多人买了一个月,新鲜劲过了就退订,找不到高频刚性的使用场景。
第二类是To B的定制服务,帮企业把内部文档、知识库改成大模型问答,帮开发自动生成代码,帮市场部写营销文案。这些需求是真实存在的,可落地障碍比你想象的多得多。
首先就是幻觉问题,大模型一本正经胡说八道,企业用来做对外的客服,说错一句话,损失可能几十万。其次是推理成本,同样处理一个用户问题,大模型推理的成本是传统关键词搜索的几十上百倍,一个千人规模的企业,一年光推理成本就得几十万,很多中小企业根本扛不住。还有数据安全,把企业的核心数据放到第三方大模型上,谁敢啊?
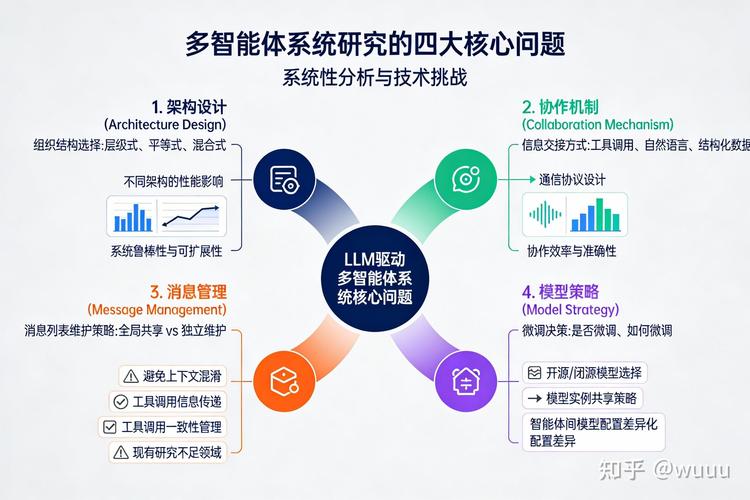 企业大语言模型应用落地架构图
不过话说回来,真的扎进某个垂直场景的玩家,已经有跑出来的苗头了。比如做代码生成的,做法律文书整理的,做医药文献检索的,这些场景不需要大模型全知全能,只要在细分领域比旧工具好用十倍,就能卖出去。我上个月接触的一家做施工图审查的创业公司,用大模型把审查效率提了八倍,原来一个工程师审一周的图,现在大模型半天就能出初审稿,订单已经排到半年后了。
未来三年:洗牌加速,赛道收窄
 未来三年:洗牌加速,赛道收窄
现在很多人还在比参数大小,比训练数据多少。未来三年,这个玩法会彻底变。
首先是基础层的洗牌,训练一个千亿参数的大模型,光GPU硬件成本就得好几个亿,加上数据、人工,一年烧十亿都是正常的。绝大多数中小玩家,根本融不到下一轮钱,撑不过2026年。最后能留在通用大模型赛场的,全世界不会超过五家,国内也就两三家顶天了。
然后是治理的收紧,大语言模型带来的深度伪造、版权纠纷、隐私泄露问题,只会越来越严重。监管一定会越来越严,没有合规资质,没有海量合法训练数据的玩家,都会被清出去。
那机会在哪里?不在通用大模型,在垂直场景的模型应用和模型微调。把通用大模型的能力,跟垂直行业的知识、数据结合,做出来比传统工具效率高一个量级的产品,这才是真的机会。很多创业者现在一头扎进通用大模型的红海,反而错过了身边近在眼前的垂直场景。
至于通用人工智能什么时候来?别盼了,未来三五年,基于Transformer架构的大语言模型,已经摸到技术瓶颈了,不会有革命性的突破了。大家要做的,就是沉下心,把场景磨透,把成本降下来,把实际问题解决掉。
大语言模型确实是近十年来科技行业最大的技术革命。它会一点点替代掉那些重复性的脑力劳动,解放更多人去做真正创造性的工作。但它不是点石成金的魔法棒,更不是资本炒概念的工具。
潮水退了,才知道谁在裸泳。再过三年,我们再看。

