存算一体:打破冯诺依曼瓶颈的下一站,到底离量产还有多远
去年ChatGPT爆火之后,圈里找下一个算力突破口的人,眼睛都盯在了存算一体上。
我去年跑半导体产业链的时候,见了三个做存算一体的创始人,两个说自己明年就能量产,一个说已经拿到了某头部手机厂的样片订单。
这个概念炒了快十年,怎么突然就落地了?说白了,都是被算力不够逼的。
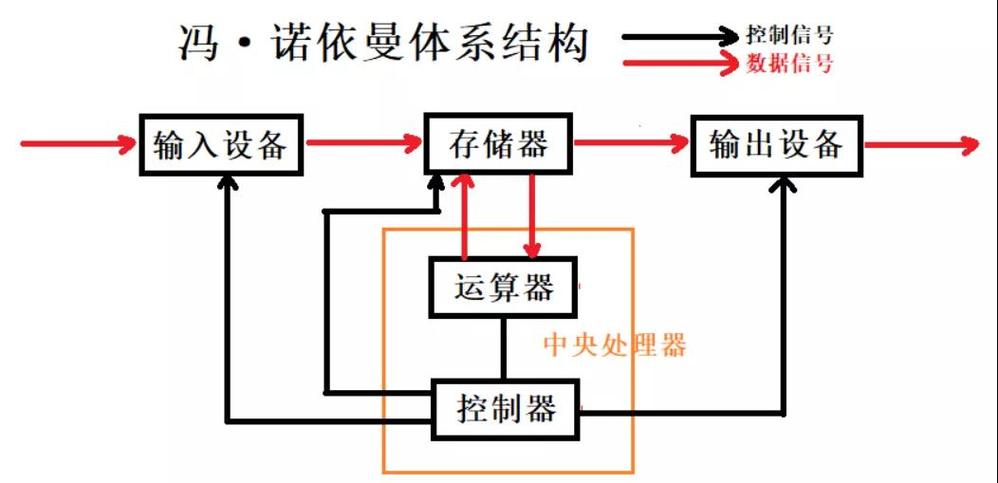 传统冯诺依曼架构存算分离示意图
存算一体的核心,其实就是换了个思路:把计算单元直接塞进存储颗粒里,不用来回搬数据,直接在存储内部完成计算。
这么做的好处很直观:相同AI推理任务,功耗能降到原来的十分之一,速度能提至少五倍。
但别被营销话术忽悠成什么革命性颠覆,它现在的技术边界很清晰——不是要替换掉现有的CPU、GPU,是给现有架构做加速补短板,尤其适合做并行AI推理,天生不适合做通用计算。
 存算一体AI芯片晶圆实物图
不过话说回来,现在落地的都还是小场景,真正大规模上消费电子和云端,还得绕开好几个坎。
第一个坎是精度。存算一体大多靠模拟计算做并行加速,精度波动比传统数字芯片大,现在做低精度推理没问题,做云端训练需要的32比特高精度,目前还达不到商用要求。
第二个坎是良率。存算一体要改存储芯片的制造工艺,计算单元和存储单元做在一起,密度上去之后良率掉得厉害,良率上不去,成本就降不下来,没法大规模走量。
第三个坎最要命:生态。现在AI开发都围着现有软件生态转,整个工具链都建好了,存算一体是新架构,要重新做编译器、做模型适配,开发者没动力转,客户也不想承担额外的迁移成本。
 未来三年:别期待革命,要看渐变
很多人说存算一体会颠覆现有半导体格局,我觉得太扯了。任何新架构的落地都是慢慢渗透的,不会一下子把旧的拍死。
未来三年,最先大规模落地的肯定是端侧低功耗AI场景:智能耳机的离线语音唤醒、智能汽车的车载语音推理、手机端的本地大模型推理,这些对功耗敏感,对精度要求不是极端高,刚好适配现在存算一体的技术能力。我敢赌,2025年之前,肯定会有旗舰手机把存算一体NPU当成核心卖点推出来。
未来五年,云端市场会出现存算一体的独立加速卡,作为GPU集群的辅助加速模块,专门处理AI推理的高并发任务,不会取代GPU,就是帮GPU省点电、提提速。
当然,风险也很明显。现在资本太热了,一堆没技术积累的团队挤进来,拿着PPT融钱,最后大概率是一地鸡毛,整个国内市场能跑出来的头部玩家不会超过五家。
从治理的角度说,存算一体其实有个意外之喜:因为数据不用流出存储芯片,所有计算都在本地完成,能减少很多数据上传云端带来的泄露风险,对用户隐私保护反而更友好。当然也有隐忧,如果别有目的的人用端侧存算一体芯片做非法AI计算,数据全程不联网,监管起来难度确实比原来大,这个是监管层需要提前布局考虑的问题。
存算一体不是什么解决算力问题的银弹,就是半导体行业为了打破冯诺依曼瓶颈,试出来的一条最靠谱的路。走得通,但是慢。
别急。
被冯诺依曼墙堵死的摩尔定律
从第一台通用计算机诞生到现在,我们用了七十多年的冯诺依曼架构,核心就是一句话:存储和计算分开。CPU负责计算,内存硬盘负责放数据,要算的时候把数据从内存搬到CPU,算完再搬回去。 摩尔定律还走得通的时候,没人觉得这是问题。CPU性能一年涨三成,功耗跟着降,大家都挺舒服。 现在呢?摩尔定律快走到物理极限了,AI大模型要处理的数据翻着倍往上涨,90%的功耗都耗在了数据来回搬的路上,真正用在计算上的不到10%。当千亿参数大模型跑一次的耗电量抵得上一个普通人十年的生活用电,这个问题已经从行业痛点变成了卡脖子的绳索。传统冯诺依曼架构存算分离示意图
存算一体的核心,其实就是换了个思路:把计算单元直接塞进存储颗粒里,不用来回搬数据,直接在存储内部完成计算。
这么做的好处很直观:相同AI推理任务,功耗能降到原来的十分之一,速度能提至少五倍。
但别被营销话术忽悠成什么革命性颠覆,它现在的技术边界很清晰——不是要替换掉现有的CPU、GPU,是给现有架构做加速补短板,尤其适合做并行AI推理,天生不适合做通用计算。
产业化的第一波落点已经清晰
说实话,前五年存算一体基本都是实验室项目,创投圈问得多、投得少,谁都怕做出来没人用。 这两年风向变了,端侧大模型起来了,手机要跑70亿参数的本地大模型,智能汽车座舱要同时跑好几个AI模型,原来的NPU功耗扛不住,发热量能把手机背盖烫得拿不住,存算一体刚好解决这个痛点。 现在行业内的进展其实很清楚:基于SRAM的存算一体,做8比特以下的低精度推理,已经有厂商实现了小批量出货,主要供给智能摄像头、可穿戴设备这些低功耗场景。基于DRAM和NAND闪存的存算一体,容量更大,适合做大参数模型,目前头部厂商都已经流出了样片,预计明后年就能批量上车。 三星去年就宣布推出了基于存算一体的AI加速芯片,给HBM高带宽内存做定制,用来加速云端大模型训练,国内的几家头部创业公司,也都拿到了头部车企和消费电子厂的定点订单。存算一体AI芯片晶圆实物图
不过话说回来,现在落地的都还是小场景,真正大规模上消费电子和云端,还得绕开好几个坎。
第一个坎是精度。存算一体大多靠模拟计算做并行加速,精度波动比传统数字芯片大,现在做低精度推理没问题,做云端训练需要的32比特高精度,目前还达不到商用要求。
第二个坎是良率。存算一体要改存储芯片的制造工艺,计算单元和存储单元做在一起,密度上去之后良率掉得厉害,良率上不去,成本就降不下来,没法大规模走量。
第三个坎最要命:生态。现在AI开发都围着现有软件生态转,整个工具链都建好了,存算一体是新架构,要重新做编译器、做模型适配,开发者没动力转,客户也不想承担额外的迁移成本。
未来三年:别期待革命,要看渐变
未来三年:别期待革命,要看渐变
很多人说存算一体会颠覆现有半导体格局,我觉得太扯了。任何新架构的落地都是慢慢渗透的,不会一下子把旧的拍死。
未来三年,最先大规模落地的肯定是端侧低功耗AI场景:智能耳机的离线语音唤醒、智能汽车的车载语音推理、手机端的本地大模型推理,这些对功耗敏感,对精度要求不是极端高,刚好适配现在存算一体的技术能力。我敢赌,2025年之前,肯定会有旗舰手机把存算一体NPU当成核心卖点推出来。
未来五年,云端市场会出现存算一体的独立加速卡,作为GPU集群的辅助加速模块,专门处理AI推理的高并发任务,不会取代GPU,就是帮GPU省点电、提提速。
当然,风险也很明显。现在资本太热了,一堆没技术积累的团队挤进来,拿着PPT融钱,最后大概率是一地鸡毛,整个国内市场能跑出来的头部玩家不会超过五家。
从治理的角度说,存算一体其实有个意外之喜:因为数据不用流出存储芯片,所有计算都在本地完成,能减少很多数据上传云端带来的泄露风险,对用户隐私保护反而更友好。当然也有隐忧,如果别有目的的人用端侧存算一体芯片做非法AI计算,数据全程不联网,监管起来难度确实比原来大,这个是监管层需要提前布局考虑的问题。
存算一体不是什么解决算力问题的银弹,就是半导体行业为了打破冯诺依曼瓶颈,试出来的一条最靠谱的路。走得通,但是慢。
别急。 
