存算一体:撬开摩尔定律囚笼的新钥匙
大模型火了一整年,圈里聊最多的除了算法就是算力。我上个月跟某云厂商的朋友吃饭,他说现在客户抢GPU抢疯了,排队三个月都提不到货。更头疼的是电费——训练一次千亿参数模型,轻轻松松烧掉大几千万。这账怎么算都吃不消。
所有人都在找新出路。存算一体就是最近被资本和产业圈捧到风口的那个答案。
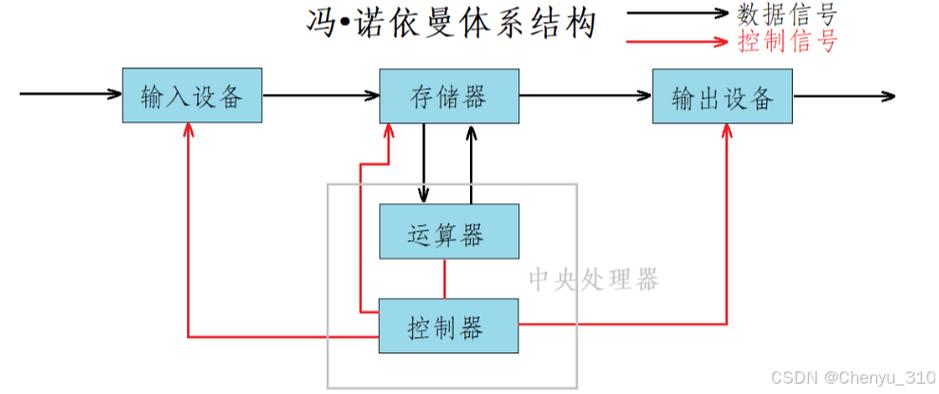 传统冯诺依曼架构数据传输路径示意图
存算一体的核心逻辑说穿了很简单:让计算直接在存储单元里做,废掉数据来回搬运这一步。理论上,能把AI推理的功耗降到原来的十分之一,性能翻好几倍。
不是说近存计算就是存算一体哦。很多厂商拿近存计算换个概念骗融资,说白了只是把存储挪得离计算单元近一点,本质还是分离,没碰到根子。真·存算一体,就是存就是算,算就是存。
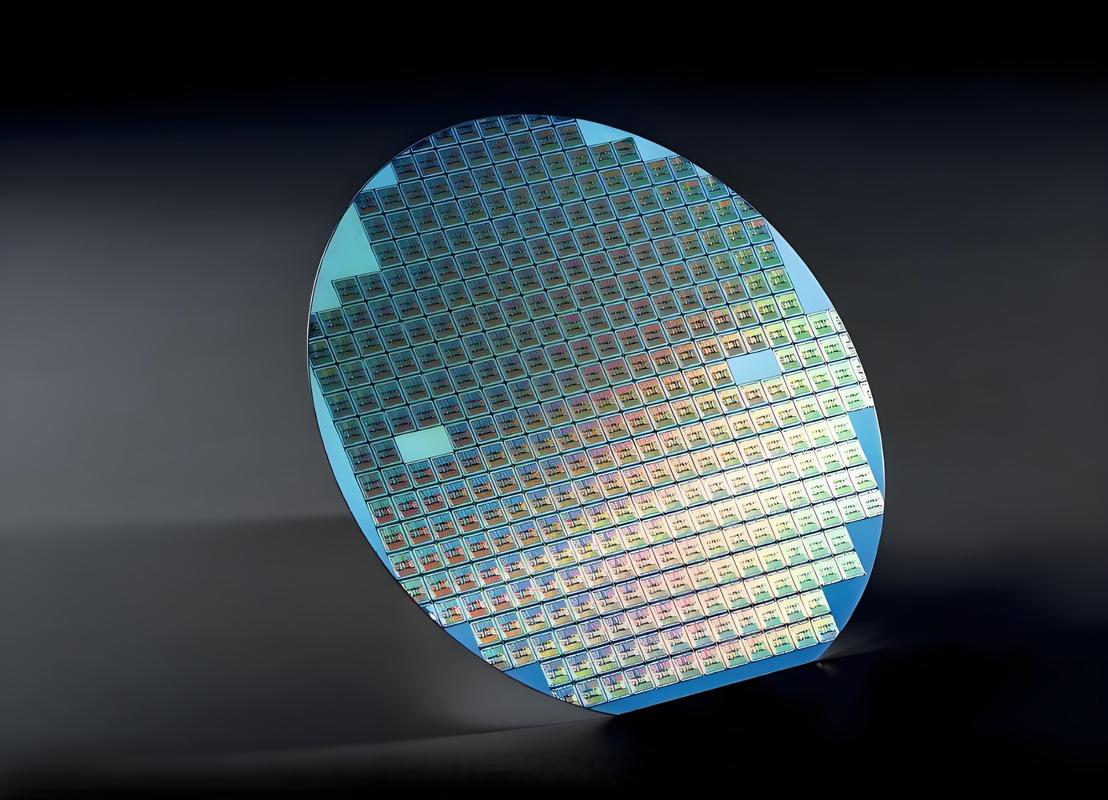 存算一体AI推理芯片晶圆实物拍摄图
不过话说回来,现在能落地的都是低精度的简单推理场景。比如语音唤醒、人脸检测这种,对精度要求不高的。真要跑千亿参数大模型,不管模拟还是数字路线,都还没摸到门。
 挡在量产前面的三道坎
技术看着美好,真要大规模商用,还有三个绕不开的坎。
第一道坎,精度。刚才说了,模拟存算一体的器件误差大,温度变一下,电阻飘一下,计算结果就错了。要做8比特以上的精度,良率直接掉的没法看。现在想做16比特精度满足大模型训练要求,难比登天。
第二道坎,生态。现在整个AI产业的开发工具链,都是基于传统GPU、CPU架构做的,CUDA生态已经筑了十几年的城墙。存算一体要想让开发者用,就得重新做编译器,重新做适配,重新搭生态,这成本不是几个亿能砸出来的。很多小公司做出来芯片,没人愿意给你开发软件,最后只能躺在实验室里。
第三道坎,成本。存算一体要做高密度的存储计算集成,对工艺要求极高,现在先进工艺下良率上不去,一片晶圆出来没几个能用的,单颗芯片成本比同性能GPU还高,谁会用?
现在很多PPT上喊着“颠覆GPU”,我只能说,醒醒。
 未来三年:先啃边缘,别碰通用
我跟不少产业专家聊过,大家共识其实很一致:未来三五年,存算一体不可能取代GPU,也不可能干掉现有的冯诺依曼架构。
最靠谱的落地方向,就是边缘侧低功耗AI场景。智能可穿戴、智能摄像头、工业传感器、车载AI这些,对功耗要求高,对算力要求不需要云端那么大,刚好匹配现在存算一体的技术能力。比如以后你的智能手表能本地跑70亿参数的大模型,不用连云端,隐私也保护了,功耗也降了,这就是存算一体的功劳。
三到五年之后,随着工艺和精度问题慢慢解决,存算一体可能会切进云端数据中心的推理市场,帮云厂商降一波电费。至于训练市场?那至少是十年以后的事了。
资本现在追热点,把存算一体吹得太神。其实技术哪有那么多颠覆,都是一步一步啃出来的。它确实是破局摩尔定律的一把好钥匙,但不是什么能秒杀一切的银弹。
给它点时间,也给产业点耐心。
冯诺依曼架构的老病根,得治
我们用了七十多年的计算机架构,核心就是冯诺依曼:存储和计算分开。你要算什么,先把数据从内存搬去计算单元,算完再搬回去。 小算力时代没问题。 当大模型参数从亿级跳到千亿级甚至万亿级,数据在存储单元和计算单元之间来回搬运的功耗,已经占到了总功耗的七成以上,留给计算的电力反而没剩下多少。这就是所有人都在说的冯诺依曼瓶颈。 摩尔定律走到尽头,工艺升级带来的性能提升,早就赶不上算力需求的暴涨了。换架构才是破局的根本。传统冯诺依曼架构数据传输路径示意图
存算一体的核心逻辑说穿了很简单:让计算直接在存储单元里做,废掉数据来回搬运这一步。理论上,能把AI推理的功耗降到原来的十分之一,性能翻好几倍。
不是说近存计算就是存算一体哦。很多厂商拿近存计算换个概念骗融资,说白了只是把存储挪得离计算单元近一点,本质还是分离,没碰到根子。真·存算一体,就是存就是算,算就是存。
产业化走到哪一步了?不是只有PPT
说实话,现在圈里一半是玩概念的,另一半真的在磨产品。 现在技术路线分成两大派:一派是模拟存算一体,利用电阻之类的模拟器件做存储计算,密度高功耗低,缺点是精度差,抗干扰能力弱,目前只能做推理,做不了训练。另一派是数字存算一体,跟现在的数字工艺兼容,精度高,但是密度和功耗优势没模拟那么大。 已经有产品出来了。国内几家头部设计公司,已经把存算一体芯片用到智能摄像头里,本地就能做人脸检测,不用把视频传云端,功耗比传统方案低一半还多。海外的话,苹果去年爆出在Apple Watch里试水存算一体,就是为了能让AI功能本地运行,不用连手机。创业公司这边,不少拿到融资的团队,今年也在出小批量试水产品,给边缘设备客户做验证。存算一体AI推理芯片晶圆实物拍摄图
不过话说回来,现在能落地的都是低精度的简单推理场景。比如语音唤醒、人脸检测这种,对精度要求不高的。真要跑千亿参数大模型,不管模拟还是数字路线,都还没摸到门。
挡在量产前面的三道坎
挡在量产前面的三道坎
技术看着美好,真要大规模商用,还有三个绕不开的坎。
第一道坎,精度。刚才说了,模拟存算一体的器件误差大,温度变一下,电阻飘一下,计算结果就错了。要做8比特以上的精度,良率直接掉的没法看。现在想做16比特精度满足大模型训练要求,难比登天。
第二道坎,生态。现在整个AI产业的开发工具链,都是基于传统GPU、CPU架构做的,CUDA生态已经筑了十几年的城墙。存算一体要想让开发者用,就得重新做编译器,重新做适配,重新搭生态,这成本不是几个亿能砸出来的。很多小公司做出来芯片,没人愿意给你开发软件,最后只能躺在实验室里。
第三道坎,成本。存算一体要做高密度的存储计算集成,对工艺要求极高,现在先进工艺下良率上不去,一片晶圆出来没几个能用的,单颗芯片成本比同性能GPU还高,谁会用?
现在很多PPT上喊着“颠覆GPU”,我只能说,醒醒。
未来三年:先啃边缘,别碰通用
未来三年:先啃边缘,别碰通用
我跟不少产业专家聊过,大家共识其实很一致:未来三五年,存算一体不可能取代GPU,也不可能干掉现有的冯诺依曼架构。
最靠谱的落地方向,就是边缘侧低功耗AI场景。智能可穿戴、智能摄像头、工业传感器、车载AI这些,对功耗要求高,对算力要求不需要云端那么大,刚好匹配现在存算一体的技术能力。比如以后你的智能手表能本地跑70亿参数的大模型,不用连云端,隐私也保护了,功耗也降了,这就是存算一体的功劳。
三到五年之后,随着工艺和精度问题慢慢解决,存算一体可能会切进云端数据中心的推理市场,帮云厂商降一波电费。至于训练市场?那至少是十年以后的事了。
资本现在追热点,把存算一体吹得太神。其实技术哪有那么多颠覆,都是一步一步啃出来的。它确实是破局摩尔定律的一把好钥匙,但不是什么能秒杀一切的银弹。
给它点时间,也给产业点耐心。 
