知识图谱:大模型热潮下被低估的AI基础设施
被大模型遮住光芒的核心技术
很多人对知识图谱的印象还停留在早期搜索引擎的关联搜索,比如你搜乔布斯,出来相关的苹果公司、库克、iPad,这就是最基础的应用。其实本质上,知识图谱是把人类的知识拆解成实体-关系-实体的结构化存储,说白了就是给AI画了一张符合人类认知的知识地图,哪条信息在哪,谁和谁是什么关系,一清二楚。
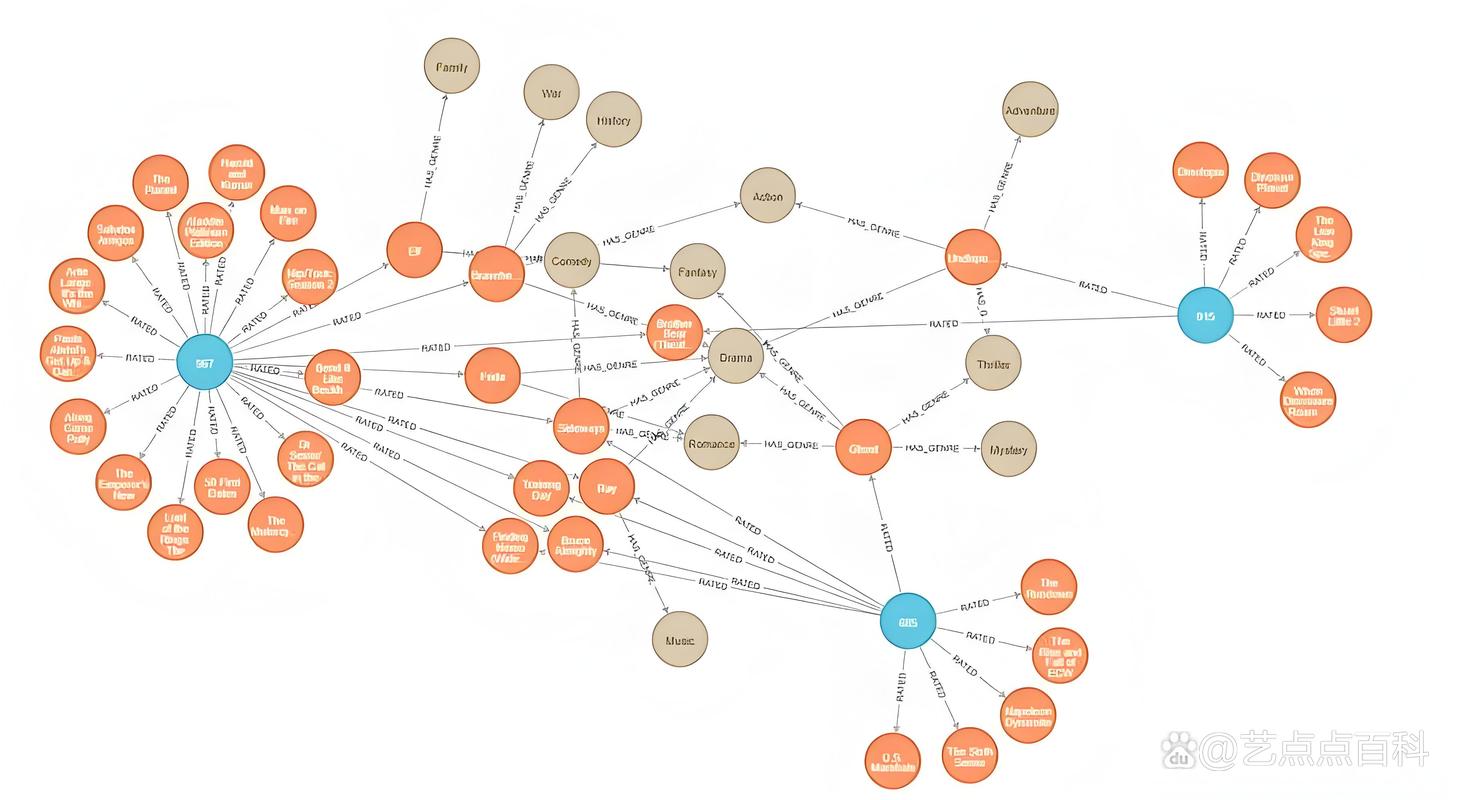 知识图谱实体关系存储示意图
大模型靠的是统计概率,把文字接龙玩到了极致,它不知道什么是真的什么是假的,只知道下一个字概率最高。知识图谱不一样,每一条关系都是可溯源、可验证的。说实话,现在大模型吹得凶,那个幻觉问题,至今只有知识图谱能给出工程上可落地的解决办法。不信你看,现在市面上能商用的大模型产品,哪家背后没挂一个千亿级的知识图谱做事实校验?
不过话说回来,知识图谱也有自己的技术边界。它做不了开放式的创意生成,也搞不了跨领域的泛化理解,构建成本还高得吓人——要梳理实体,要标注关系,垂直领域的知识图谱,光梳理行业规则就要花半年,还得不断更新,不然知识就过时了。这也是为什么前几年知识图谱风口过了之后,很多创业公司倒了的原因。
产业落地的真问题:不是没有需求,是供需错配
现在知识图谱真正跑通的商业化场景,其实都在产业端,To C的少,To B的多。
最成熟的是金融。银行做反欺诈,原来靠规则,靠单一数据,现在骗子都是团伙作案,一个人开几十个账户,分散在全国各地,靠原来的方法根本查不出来。用知识图谱一拉,把账户、手机号、IP地址、社交关系连起来一看,整个诈骗团伙的关系网一目了然,抓异常太容易了。我听过一个股份制银行的数据,上线知识图谱反欺诈系统之后,伪卡欺诈损失降了快六成,这都是真金白银的收益。
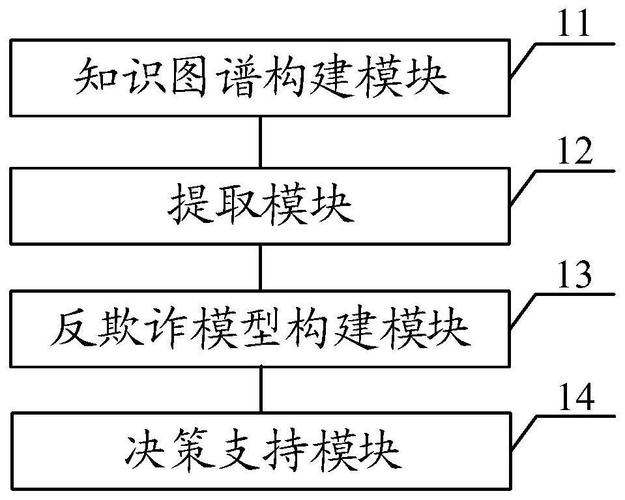 金融反欺诈知识图谱应用结构图
第二个大场景是医疗。现在做辅助诊断,做合理用药审核,知识图谱是核心。把所有的药品、适应症、禁忌、相互作用整理成结构化的知识,AI开处方的时候一查就能秒出提醒,比人工审核快得多,准确率也高。还有电商的个性化推荐,内容平台的标签体系,本质上都是知识图谱的延伸。
但是落地的障碍真的不少。第一,数据拿不到。很多垂直行业的知识都是散在各个机构手里,不会开放,比如医疗数据,法律的判例,别说公开了,内部打通都难。第二,标准不统一。你做你的医疗知识图谱,我做我的,同一个病名,你叫冠心病,我写冠状动脉粥样硬化性心脏病,实体对齐都要花一半的成本,根本没法复用。第三,太贵了。一个中型银行做一套定制化的知识图谱系统,加上实施服务费,大几百万扔进去,中小机构根本玩不起。
说白了,现在知识图谱的供给,还是高端定制化的路子,一个项目做半年,收几百万,做不了规模化,也就做不出大公司。这是当前产业最尴尬的地方。
未来三年:融合才是唯一的出路
 未来三年:融合才是唯一的出路
很多人说知识图谱会被大模型取代,我敢说不可能。反而未来三年,知识图谱的价值会重新被抬起来,核心逻辑就是大模型的产业化落地,离不开知识图谱补短板。
现在业界已经有了共识,就是“大模型+知识图谱”的混合架构,大模型负责自然语言理解和生成,知识图谱负责事实存储和逻辑校验,刚好互补。比如给企业做客服大模型,用户问你们公司的产品保修政策是什么,大模型从知识图谱里抓出准确的政策内容再生成回答,根本不会胡说八道,比纯大模型靠谱一百倍。
当然风险也不能忽视。知识图谱把所有实体和关系关联起来,对隐私的挑战比普通的大数据大得多。比如把你的出行数据、消费数据、社交数据都放到知识图谱里一关联,你是什么人,每天在哪,跟谁来往,一清二楚,稍微漏一点就是大问题。还有知识的偏见问题,如果构建知识图谱的时候用的数据本身就带偏见,比如认为程序员都是男性,护士都是女性,这种偏见会被固化下来,比大模型的偏见更难纠正。
治理层面现在还滞后,毕竟大家的注意力都在大模型上,还没轮到知识图谱。不过话说回来,技术本身就是中性的,关键看怎么用。
对未来三年,我两个判断:第一,知识图谱会从一个独立的技术方向,变成大模型产业化的标配基础设施,不会单独拿出来炒概念,但会成为所有商用AI项目的标配。第二,垂直领域的通用知识图谱会出来,比如医疗、金融、工业每个领域都会出现做好了实体对齐、更新维护的现成知识图谱产品,中小企业不用再花几百万自己做,拿过来就能用,产业化的门槛会大幅降下来。
说实话,科技圈从来都是这样,一波新概念起来,就把老技术踩进泥里,等真落地了才发现,老技术才是压舱石。知识图谱不是过去式,是大模型时代的定海神针,不信你等着看。

