自然语言处理:距离真正的「懂人话」还有多远?
打开手机输入法的联想词,和AI助手聊半小时天,给合同自动标红风险条款,甚至接到一通AI换脸换声的诈骗电话——你我今天早就在不知不觉中,天天泡在自然语言处理(NLP)的应用里了。
说实话,大部分人对NLP的认知,都被这两年爆火的大模型带歪了。好像NLP就是堆参数、聊天、写文案,只要参数够大就能解决所有问题。
吹过的牛,迟早要破。
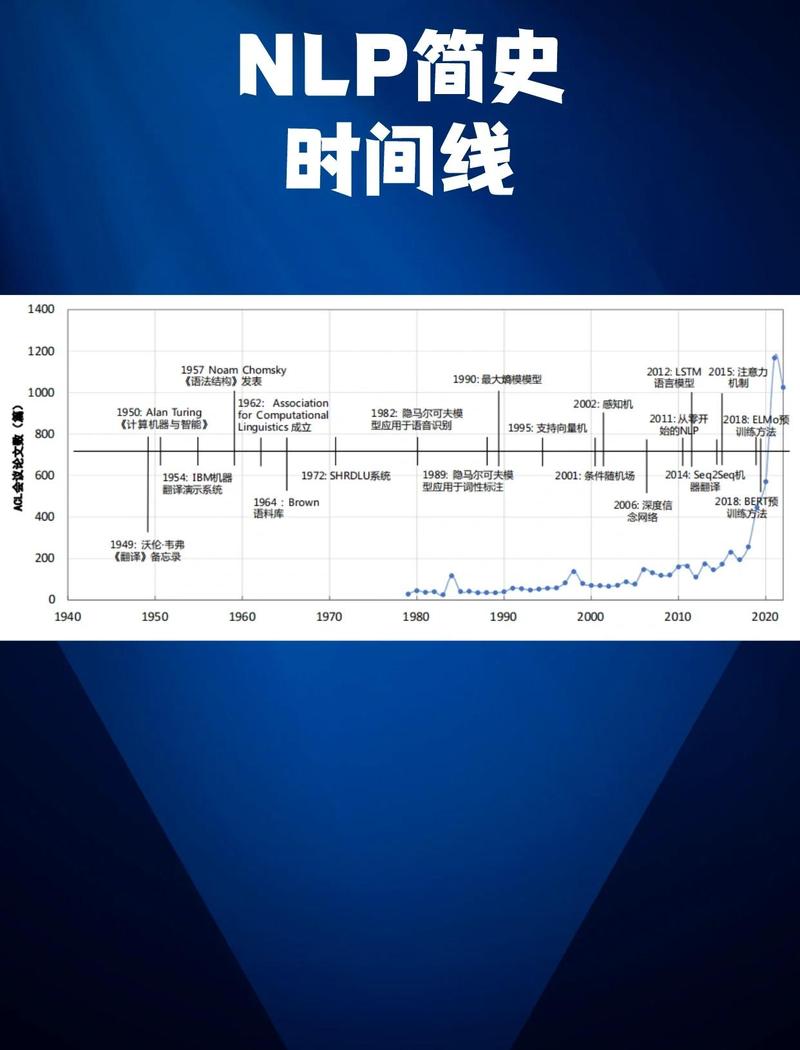 自然语言处理技术发展时间线
现在行业里最大的误区,就是觉得参数越大,NLP能力越强。说白了,参数堆出来的通用能力,看起来样样行,真到具体场景里,就是处处不够用。
不过话说回来,大模型确实把NLP的基础能力拉上去了。原来需要单独做训练的命名实体识别、情感分类这些基础任务,现在用预训练模型微调一下,效果就能超过原来的小模型。这是过去五年最大的进展,没错。
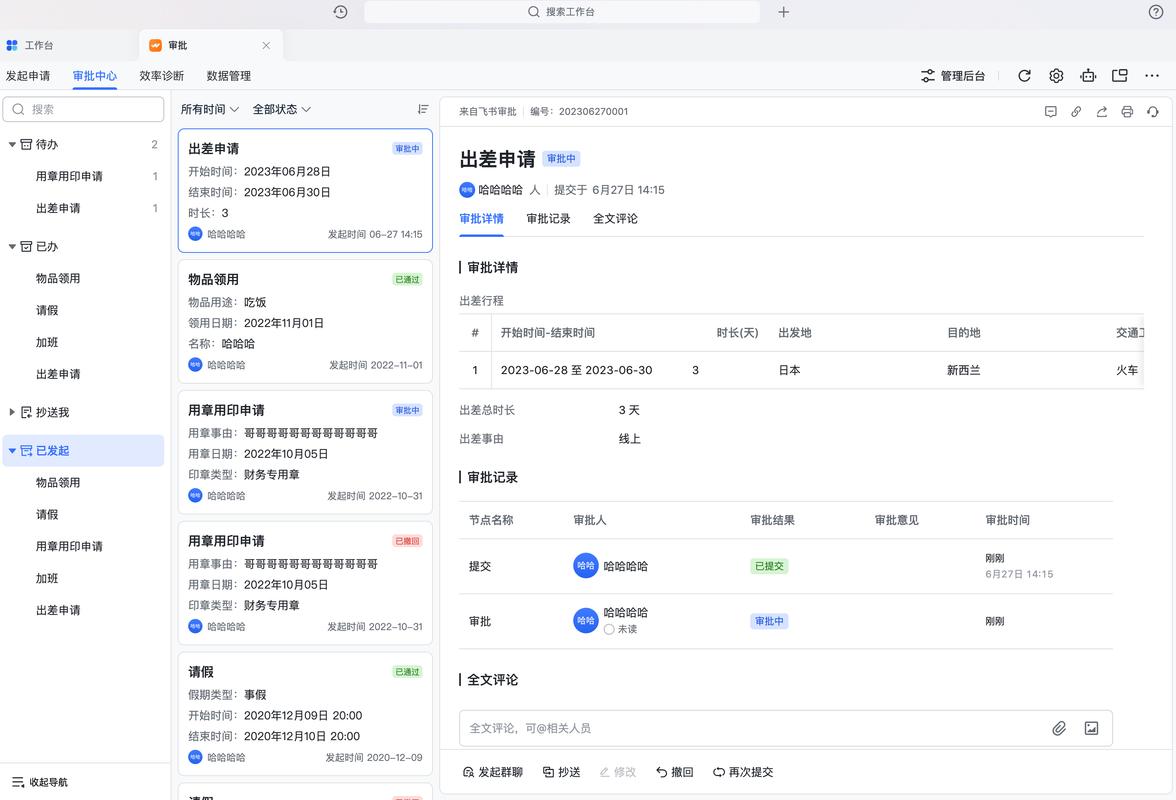 自然语言处理金融合同审核应用界面
但落地障碍也真的很明显。第一个就是垂直领域的标注数据太贵了。你要做中医医案的NLP分析,标注数据得找副主任医师以上的人来标,一天一个人标不了几十份,成本高到吓死人。第二个就是容错率太低,金融合同里的金额错一个零,法律文书里的主体搞错,那就是天大的责任,客户要求准确率必须接近百分之百,差一点都不能用。
现在很多通用大模型喊着要落地B端,一年下来签不了几个正式订单,核心原因就在这:通用模型的泛化能力,撑不起垂直场景的苛刻要求。
至于C端,现在能赚到钱的NLP也不是聊天机器人,更多是藏在背后的功能,比如短视频的字幕自动生成、直播的违禁词审核、输入法的联想,这些都是NLP,只是你感觉不到而已。
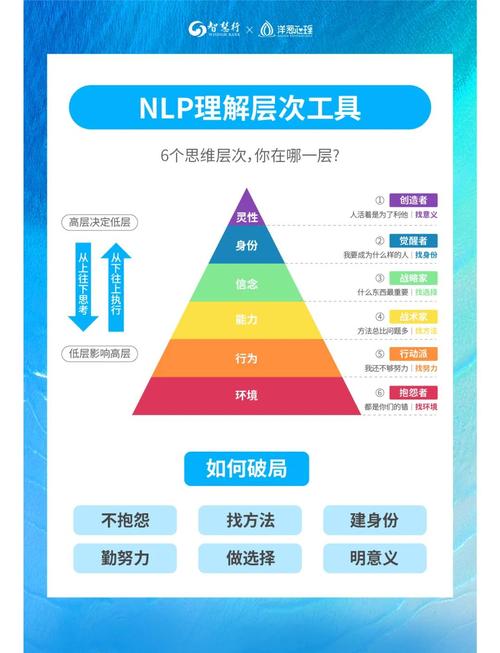 未来3到5年:NLP会回到它该有的位置
先说说风险。现在NLP带来的伦理和治理问题,已经摆在台面上了。AI换声音伪造老板指令诈骗,AI生成虚假软文批量发稿,深度伪造的内容越来越逼真,普通人根本分不出来。这块的监管现在还是滞后的,很多灰色地带没人管,未来肯定会出更明确的规则,不符合要求的NLP产品肯定会被清出去。
还有隐私问题,NLP要处理大量用户的文字、语音数据,很多敏感信息一不小心就泄露了,这块的合规成本未来会越来越高。
那未来3到5年,NLP会怎么走?我个人判断有两个清晰的方向。
第一个是垂直领域的小模型会重新起来。通用大模型会变成水电一样的基础设施,给大家提供基础NLP能力,但真正赚大钱的,一定是在某个垂直领域做精的小NLP模型。做电力工单分析就专门做电力,做医美病历就专门做医美,参数不用千亿,几百亿甚至几十亿就够,成本低,准确率高,客户愿意买单。
第二个是NLP会彻底和多模态融合,不会再有单独的纯NLP产品了。以后处理信息,都是文字加语音加图像一起分析,比如给医院做NLP,不仅要处理医生的口述文字,还要识别手写病历、胶片上的文字,一起整合出结构化信息,准确率比纯文字处理高太多。
最后说一句,至少未来五年,NLP还是人类的辅助工具,取代不了核心的文字工作。写社论要它出初稿可以,最后定调子还是得人;审合同它帮你标风险可以,最后签字还是得律师拍板。
别想着一步登天让机器彻底懂人话。能在具体场景帮人类省时间、多赚钱,就是NLP最好的样子。
NLP的本质,从来不是堆参数猜下一个字
从最早的规则匹配,到后来的统计语言模型,再到今天的预训练大模型,NLP走了七十多年,核心目标从来没变过:让机器能听懂、看懂、生成人类的自然语言。 但很多人搞反了逻辑。现在的大模型,本质还是基于统计概率的语义拟合,不是真的「理解」人类语言。你给它说一句「咬死了猎人的狗」,它能给你分出好几种完全不同的语义,很多时候还是会搞不清到底是狗被咬了还是猎人被咬了。 人类语言的歧义、省略、双关、语境依赖,本来就是刻在基因里的。我们聊天的时候,一个眼神、一个停顿,意思能差十万八千里,机器哪能那么容易学明白。自然语言处理技术发展时间线
现在行业里最大的误区,就是觉得参数越大,NLP能力越强。说白了,参数堆出来的通用能力,看起来样样行,真到具体场景里,就是处处不够用。
不过话说回来,大模型确实把NLP的基础能力拉上去了。原来需要单独做训练的命名实体识别、情感分类这些基础任务,现在用预训练模型微调一下,效果就能超过原来的小模型。这是过去五年最大的进展,没错。
产业落地:赚得到钱的NLP,都不在聚光灯下
你去看今年一级市场的NLP项目,凡是张嘴就说要做通用对话大模型的,基本都拿不到新融资了。资本现在学乖了,只投能快速出收入的项目。 真正盈利的NLP项目,大多藏在B端的垂直场景里,根本没人出来炒作。 我接触过一家给国内顶级律所做NLP服务的创业公司,总共才二十多个人,一年能赚大几千万。他们做的事情说起来也不复杂:就是给法律判决书、合同做语义抽取,自动梳理争议焦点、匹配同类判例,原来一个律师做一个项目要三天整理材料,现在半小时就能出结果。客单价按年算,一个客户几十万,根本不愁订单。 还有金融行业,卖方研报那么多,基金公司要找某一个行业某一个公司的核心观点,原来要靠研究员一篇一篇翻,用NLP自动抽取关键词和核心结论,几秒钟就能跑完。这块的需求大到离谱。自然语言处理金融合同审核应用界面
但落地障碍也真的很明显。第一个就是垂直领域的标注数据太贵了。你要做中医医案的NLP分析,标注数据得找副主任医师以上的人来标,一天一个人标不了几十份,成本高到吓死人。第二个就是容错率太低,金融合同里的金额错一个零,法律文书里的主体搞错,那就是天大的责任,客户要求准确率必须接近百分之百,差一点都不能用。
现在很多通用大模型喊着要落地B端,一年下来签不了几个正式订单,核心原因就在这:通用模型的泛化能力,撑不起垂直场景的苛刻要求。
至于C端,现在能赚到钱的NLP也不是聊天机器人,更多是藏在背后的功能,比如短视频的字幕自动生成、直播的违禁词审核、输入法的联想,这些都是NLP,只是你感觉不到而已。
未来3到5年:NLP会回到它该有的位置
未来3到5年:NLP会回到它该有的位置
先说说风险。现在NLP带来的伦理和治理问题,已经摆在台面上了。AI换声音伪造老板指令诈骗,AI生成虚假软文批量发稿,深度伪造的内容越来越逼真,普通人根本分不出来。这块的监管现在还是滞后的,很多灰色地带没人管,未来肯定会出更明确的规则,不符合要求的NLP产品肯定会被清出去。
还有隐私问题,NLP要处理大量用户的文字、语音数据,很多敏感信息一不小心就泄露了,这块的合规成本未来会越来越高。
那未来3到5年,NLP会怎么走?我个人判断有两个清晰的方向。
第一个是垂直领域的小模型会重新起来。通用大模型会变成水电一样的基础设施,给大家提供基础NLP能力,但真正赚大钱的,一定是在某个垂直领域做精的小NLP模型。做电力工单分析就专门做电力,做医美病历就专门做医美,参数不用千亿,几百亿甚至几十亿就够,成本低,准确率高,客户愿意买单。
第二个是NLP会彻底和多模态融合,不会再有单独的纯NLP产品了。以后处理信息,都是文字加语音加图像一起分析,比如给医院做NLP,不仅要处理医生的口述文字,还要识别手写病历、胶片上的文字,一起整合出结构化信息,准确率比纯文字处理高太多。
最后说一句,至少未来五年,NLP还是人类的辅助工具,取代不了核心的文字工作。写社论要它出初稿可以,最后定调子还是得人;审合同它帮你标风险可以,最后签字还是得律师拍板。
别想着一步登天让机器彻底懂人话。能在具体场景帮人类省时间、多赚钱,就是NLP最好的样子。 
