多模态大模型:从概念狂欢到产业落地的真问题
上个月在深圳喝早茶,碰到一个做AI的创始人,头发掉了一半,开口就是吐槽。上半年靠“多模态大模型”的概念拿了两轮融资,前后小一个亿,全砸进预训练和调参了,现在账上的钱撑不过三个月,连一个能稳定收钱的落地场景都没摸出来。
“所有人都在说多模态好,我怎么就赚不到钱呢?”
其实不止他迷茫。从OpenAI放出GPT-4V开始,国内大模型厂商全往多模态赛道挤,发布会开了一场接一场,参数越吹越大,能落地的真东西没见多少。
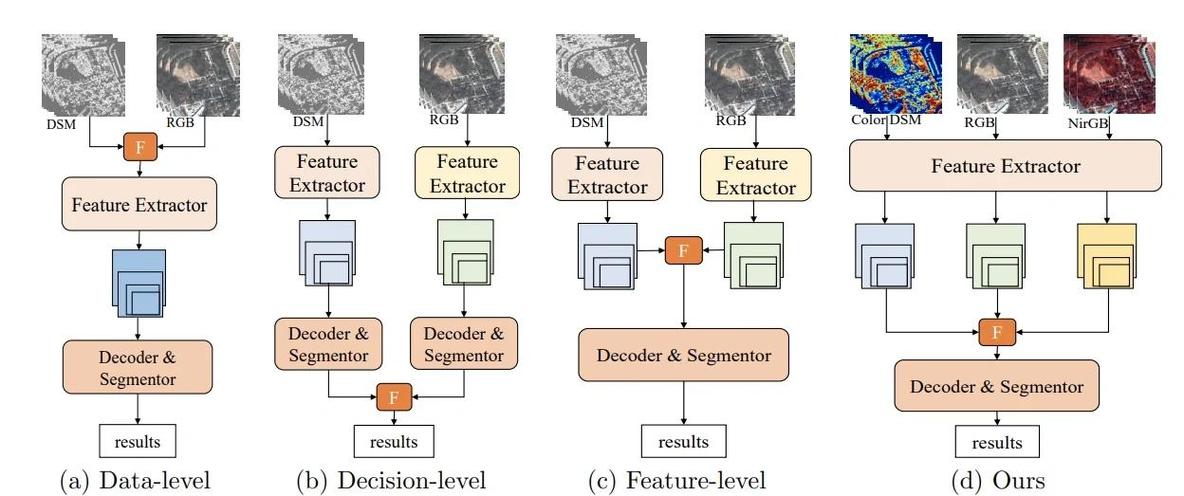 多模态大模型跨模态语义映射示意图
这话水份很大。目前最顶级的GPT-4V,也就能做一些浅层次的跨模态推理,你给它一张复杂的机械设计图纸,让它把图纸上的尺寸标注抽出来,再转成可以直接加工的G代码,它根本做不到。
很多创业公司拿着开源预训练模型改个接口,就敢说自己“全场景通用多模态”,骗投资人钱可以,真要干活立马露馅。
说实话,目前多模态能稳定解决的问题,都还是“把不同类型信息整合起来,降低人工整理的成本”,远没到颠覆行业的地步。
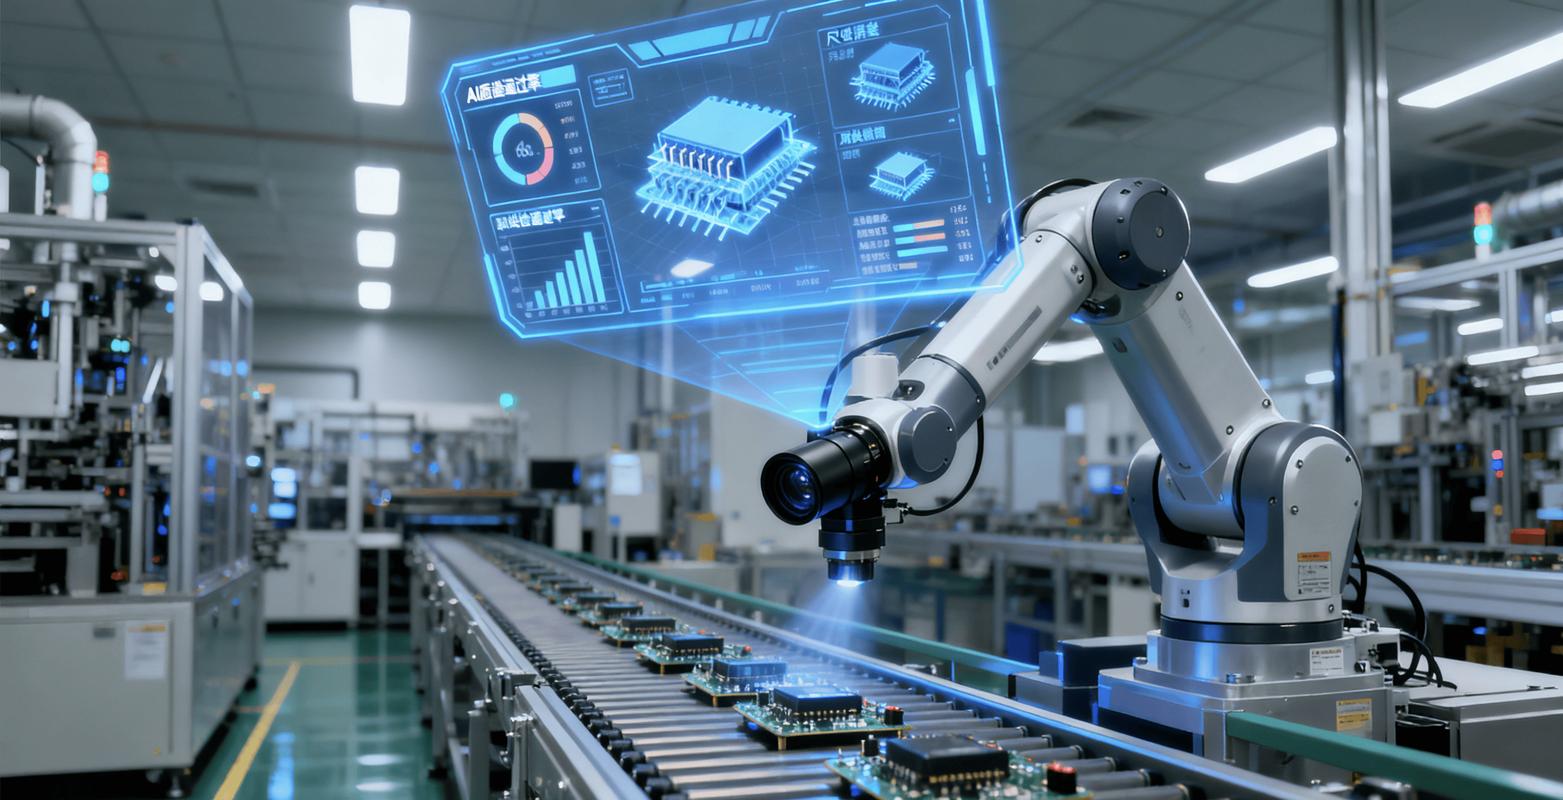 多模态大模型工业AI质检应用现场图
不过话说回来,落地的坑也不少。最大的问题就是数据。垂直场景的多模态数据标注成本,是纯文本的十几倍,你要标一段工业设备的异常音频,还要对应上故障类型,没有专业工程师根本标不对。
还有数据隐私,工厂不可能把核心产品的设计图、生产数据往外拿,所以现在大多数落地项目,都是把模型放在客户本地做微调,数据不出园,才能谈得下来。
 未来三年,谁能笑到最后
先掰扯清楚绕不开的风险。现在多模态的治理和伦理问题,已经越来越突出。深度伪造现在能做到换脸换音几乎以假乱真,最近已经有骗子用多模态模型伪造老板的声音和视频,骗走了财务几百万,这种案例以后只会越来越多。
还有版权问题,训练多模态大模型用的图像、音频,大部分都是没授权的,已经有好多作者起诉大模型厂商侵权了,这个雷早晚要爆。
聊完风险,说点实在的判断。
第一,通用多模态大模型的赛道,最后就是三五家顶级玩家能玩,不管是国内还是国外,中小创业公司别碰,训练一次就是几个亿的成本,你耗不起,也拼不过头部的算力和数据储备。
第二,垂直领域的应用玩家,只要攥住了具体场景,能帮客户真的降本增效,就能活的很好。比如做骨科多模态的,把CT影像、病人病历、临床指南整合起来,帮医生快速写诊断报告,这个就是刚需,医院愿意掏钱。再比如做电商的,把商品图、详情页文案、用户评价整合起来,自动生成直播脚本和主播话术,也是实打实降本。
第三,多模态不会在未来三年取代多少上班族,只会把人从重复的体力劳动里解放出来。原来设计师要花一周改十版图,现在用多模态一天就能出十版,设计师不用抠细节了,只要负责把控创意和方向就行。说白了,多模态就是个效率工具,别吹得太神。
去年到今年,多模态概念炒了快两年了,挤挤水份,剩下的才是真机会。别跟着概念跑,盯着客户的痛点走,能解决问题,才能赚到钱。
别被概念裹着走,多模态的核心到底是什么
原来的大模型,不管是早期BERT还是GPT,都是单模态,只处理文本。你给它一张图,它不认,给它一段音频,它也处理不了。 多模态大模型的核心,说穿了也不复杂,就是把文字、图像、音频、视频甚至工业传感器信号这些不同格式的信息,映射到同一个语义空间里,让模型能真的“看懂”“听懂”不同类型的信息,再统一输出结果。多模态大模型跨模态语义映射示意图
这话水份很大。目前最顶级的GPT-4V,也就能做一些浅层次的跨模态推理,你给它一张复杂的机械设计图纸,让它把图纸上的尺寸标注抽出来,再转成可以直接加工的G代码,它根本做不到。
很多创业公司拿着开源预训练模型改个接口,就敢说自己“全场景通用多模态”,骗投资人钱可以,真要干活立马露馅。
说实话,目前多模态能稳定解决的问题,都还是“把不同类型信息整合起来,降低人工整理的成本”,远没到颠覆行业的地步。
跑通付费的场景,都藏在你看不见的地方
大家平时刷新闻,看到最多的就是多模态做文生图、AI聊天、数字人,其实这些To C的场景,99%都还在赚吆喝,没找到稳定的变现模式。 真正能收钱、跑通复购的多模态项目,全在垂直To B领域。 举个例子,国内汽车零配件厂商的生产线质检,原来用传统的计算机视觉模型,每换一款新产品,就要重新标注几千张缺陷图,少则一周多则半个月,成本高到吓人。现在用多模态大模型,工程师只要把缺陷的文字描述写清楚,再配上几十张样图,模型就能自己把文字描述和图像特征对齐,当天就能上线用,准确率比传统CV还高10%到15%。 国内已经有头部车企的工厂,整条线都换成了多模态质检方案,一个工位年服务费几十万,厂商愿意掏钱,因为确实省了人工和停线的成本。 还有影视内容行业,做纪录片或者综艺的,素材库动辄几千小时,原来剪辑师找素材要翻好几天,现在用多模态模型,把文案脚本喂进去,模型能自动识别画面内容、音频台词,几分钟就能把符合要求的片段都抠出来,还能自动对齐字幕,效率至少提了十倍。多模态大模型工业AI质检应用现场图
不过话说回来,落地的坑也不少。最大的问题就是数据。垂直场景的多模态数据标注成本,是纯文本的十几倍,你要标一段工业设备的异常音频,还要对应上故障类型,没有专业工程师根本标不对。
还有数据隐私,工厂不可能把核心产品的设计图、生产数据往外拿,所以现在大多数落地项目,都是把模型放在客户本地做微调,数据不出园,才能谈得下来。
未来三年,谁能笑到最后
未来三年,谁能笑到最后
先掰扯清楚绕不开的风险。现在多模态的治理和伦理问题,已经越来越突出。深度伪造现在能做到换脸换音几乎以假乱真,最近已经有骗子用多模态模型伪造老板的声音和视频,骗走了财务几百万,这种案例以后只会越来越多。
还有版权问题,训练多模态大模型用的图像、音频,大部分都是没授权的,已经有好多作者起诉大模型厂商侵权了,这个雷早晚要爆。
聊完风险,说点实在的判断。
第一,通用多模态大模型的赛道,最后就是三五家顶级玩家能玩,不管是国内还是国外,中小创业公司别碰,训练一次就是几个亿的成本,你耗不起,也拼不过头部的算力和数据储备。
第二,垂直领域的应用玩家,只要攥住了具体场景,能帮客户真的降本增效,就能活的很好。比如做骨科多模态的,把CT影像、病人病历、临床指南整合起来,帮医生快速写诊断报告,这个就是刚需,医院愿意掏钱。再比如做电商的,把商品图、详情页文案、用户评价整合起来,自动生成直播脚本和主播话术,也是实打实降本。
第三,多模态不会在未来三年取代多少上班族,只会把人从重复的体力劳动里解放出来。原来设计师要花一周改十版图,现在用多模态一天就能出十版,设计师不用抠细节了,只要负责把控创意和方向就行。说白了,多模态就是个效率工具,别吹得太神。
去年到今年,多模态概念炒了快两年了,挤挤水份,剩下的才是真机会。别跟着概念跑,盯着客户的痛点走,能解决问题,才能赚到钱。 
