生成式人工智能:我们摸到的是未来,还是泡沫边缘?
去年春天跟几个做投资的朋友挤在硅谷酒店的过道里看GPT-4发布会,屏幕上弹出那张亲手做的“鸡能不能站在树上”的梗图的时候, whole room炸了。
有人当场拍板要投三个生成式AI项目,有人皱着眉说这不就是高级 autocomplete吗?
吵到最后没人记得结论,只记得所有人都清楚:这东西不一样了。
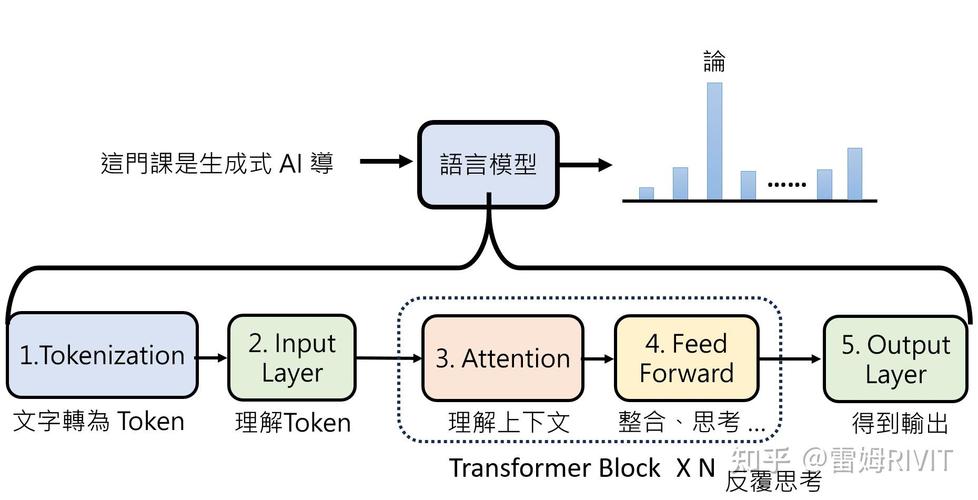 生成式人工智能大语言模型token预测流程示意图
说实话,原理说出来一点都不玄乎。但就是这个逻辑,把AI的能力边界拓宽了不止一个量级。
你要让传统AI帮你写一份春节活动的营销文案,它只能从库里扒现成的模板给你改几个字。生成式AI能直接给你出十份不同风格的全新文案,还能帮你把海报文案也一起写了。
但也要说清楚,它至今都没有“理解”这个世界。你让它算1327乘以965,它大概率会算错。因为它不是真的在做乘法,它只是在按照概率拼出看起来对的答案。幻觉,至今都是悬在所有生成式AI头上的利剑。
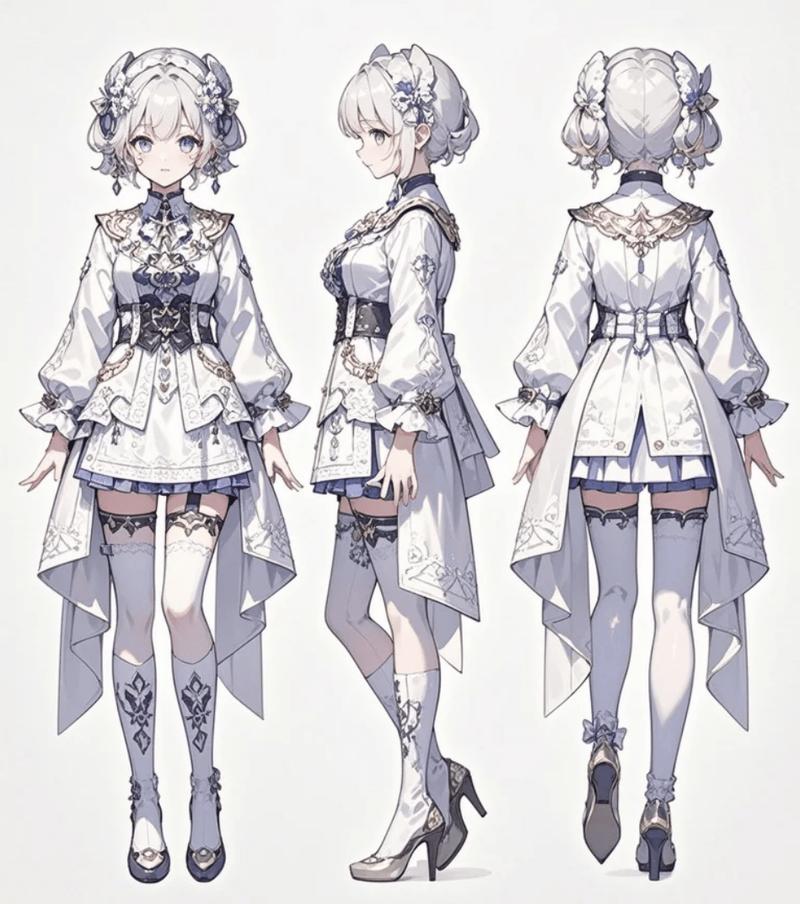 生成式人工智能游戏角色原画生成落地示例图
不过话说回来,大部分跟风进场的企业都没赚到钱。我见过不少传统行业的老板,花几百万买了大模型接入,结果发现自己公司连干净的内部数据都整理不出来,最后大模型就用来帮行政写写节日祝福,太浪费了。
落地最大的障碍从来都不是技术,是业务匹配。你一个做制造业的,非要凑通用大模型的热闹,不如花几十万训练一个专属于你的设备故障检修问答模型,真的能帮工程师省好多翻手册的时间,这才是有用的。
现在产业链已经分的很清楚了:上游做通用大模型训练的,就那么几家能玩得起,训练一次要烧好几亿,中小玩家根本碰不起。中游做微调、做数据清洗的,给下游企业做落地服务,已经活的很舒服了。下游垂直领域的应用,才是现在最多机会的地方。
 未来3-5年:规则和格局会怎么变
现在绕不开的就是风险和治理。
第一个问题是版权。现在所有大模型的训练数据,大部分都是从互联网爬来的有版权的内容,作家、摄影师、画家的作品没经过授权就被拿去训练,已经有一大堆官司在排队了。未来几年,一定会出来一套清晰的训练数据版权规则,要么给创作者付费,要么只能用公开授权的数据,这会直接改变大模型的成本结构。
第二个问题是安全。深度伪造现在已经能做到以假乱真了,针对普通人的AI诈骗越来越多,换脸骗钱、仿造领导人讲话,防不胜防。现在各国都在出规则,欧盟的AI法案把生成式AI分了等级,高风险的应用要严格审核,国内也出了生成式AI服务管理的规定,未来对生成内容的溯源要求一定会越来越严。
关于未来3-5年,我有三个判断:
第一,通用大模型一定会变成少数头部公司掌控的基础设施,就像现在的水电煤一样,中小玩家不用再妄想做通用大模型弯道超车了。
第二,垂直领域的生成式AI应用会爆发,每个行业都会有专为这个行业训练的垂直模型,比通用模型精度更高、成本更低,更贴合行业需求。
第三,不会有一半的工作被替代,但大部分工作的内容都会被改变。原来你花80%的时间写初稿、找资料,未来这些活都交给AI,你只需要做判断、做创意、做跟人沟通的部分。
说实话,这一轮生成式AI热,跟之前的互联网金融热、元宇宙热一样,肯定会有一堆泡沫破掉,一堆公司死掉。但跟之前那些概念不一样的是,这一次真的有能落地的东西,真的改变了很多行业的效率。
你可以不投资它,你不能不用它。现在你打开Word都有AI帮你写文案了,对吧?
至于未来会不会真的出来通用人工智能,那是十年后的事情了。我们先把这三五年的日子过好再说。
到底哪里不一样:核心逻辑的颠覆
生成式AI和传统AI最核心的区别,是输出从“给定选项内的选择”变成了“从未存在过的新内容”。 之前的人工智能,不管是用来人脸识别还是推荐商品,本质都是“分类+检索”:你给我输入,我从训练好的库里找最匹配的结果给你。 生成式人工智能不是这样。它学完所有互联网上的文字、图片、代码之后,学会的是根据你给的开头,一个字一个字预测下一个最可能出现的内容。拼起来,就是一整篇通顺的文章、一张完整的图、一段能跑的代码。生成式人工智能大语言模型token预测流程示意图
说实话,原理说出来一点都不玄乎。但就是这个逻辑,把AI的能力边界拓宽了不止一个量级。
你要让传统AI帮你写一份春节活动的营销文案,它只能从库里扒现成的模板给你改几个字。生成式AI能直接给你出十份不同风格的全新文案,还能帮你把海报文案也一起写了。
但也要说清楚,它至今都没有“理解”这个世界。你让它算1327乘以965,它大概率会算错。因为它不是真的在做乘法,它只是在按照概率拼出看起来对的答案。幻觉,至今都是悬在所有生成式AI头上的利剑。
产业落地:真正赚到钱的都藏在水下
一提到生成式人工智能,大部分人第一反应就是ChatGPT、Midjourney这些C端产品。实际上,赚真钱的项目大多都在B端,藏在各个行业的后台里。 我上个月跟一家国内游戏公司的技术负责人吃饭,他说他们公司现在立项新项目,美术初稿80%都是生成式AI出的。原来一个原画师画一张角色草图要三天,现在AI十分钟出十张,原画师只需要挑一张改细节,成本直接砍了七成。 不止游戏。现在新药研发领域,生成式AI已经用来筛选小分子化合物结构了。原来研发一个新药要筛几万种结构,花五到十年,现在AI能把筛选时间压缩到几个月,已经有好几款AI辅助发现的候选药进入临床阶段了。还有代码领域,GitHub Copilot早就是很多程序员的标配了,至少能省一半写重复代码的时间。生成式人工智能游戏角色原画生成落地示例图
不过话说回来,大部分跟风进场的企业都没赚到钱。我见过不少传统行业的老板,花几百万买了大模型接入,结果发现自己公司连干净的内部数据都整理不出来,最后大模型就用来帮行政写写节日祝福,太浪费了。
落地最大的障碍从来都不是技术,是业务匹配。你一个做制造业的,非要凑通用大模型的热闹,不如花几十万训练一个专属于你的设备故障检修问答模型,真的能帮工程师省好多翻手册的时间,这才是有用的。
现在产业链已经分的很清楚了:上游做通用大模型训练的,就那么几家能玩得起,训练一次要烧好几亿,中小玩家根本碰不起。中游做微调、做数据清洗的,给下游企业做落地服务,已经活的很舒服了。下游垂直领域的应用,才是现在最多机会的地方。
未来3-5年:规则和格局会怎么变
未来3-5年:规则和格局会怎么变
现在绕不开的就是风险和治理。
第一个问题是版权。现在所有大模型的训练数据,大部分都是从互联网爬来的有版权的内容,作家、摄影师、画家的作品没经过授权就被拿去训练,已经有一大堆官司在排队了。未来几年,一定会出来一套清晰的训练数据版权规则,要么给创作者付费,要么只能用公开授权的数据,这会直接改变大模型的成本结构。
第二个问题是安全。深度伪造现在已经能做到以假乱真了,针对普通人的AI诈骗越来越多,换脸骗钱、仿造领导人讲话,防不胜防。现在各国都在出规则,欧盟的AI法案把生成式AI分了等级,高风险的应用要严格审核,国内也出了生成式AI服务管理的规定,未来对生成内容的溯源要求一定会越来越严。
关于未来3-5年,我有三个判断:
第一,通用大模型一定会变成少数头部公司掌控的基础设施,就像现在的水电煤一样,中小玩家不用再妄想做通用大模型弯道超车了。
第二,垂直领域的生成式AI应用会爆发,每个行业都会有专为这个行业训练的垂直模型,比通用模型精度更高、成本更低,更贴合行业需求。
第三,不会有一半的工作被替代,但大部分工作的内容都会被改变。原来你花80%的时间写初稿、找资料,未来这些活都交给AI,你只需要做判断、做创意、做跟人沟通的部分。
说实话,这一轮生成式AI热,跟之前的互联网金融热、元宇宙热一样,肯定会有一堆泡沫破掉,一堆公司死掉。但跟之前那些概念不一样的是,这一次真的有能落地的东西,真的改变了很多行业的效率。
你可以不投资它,你不能不用它。现在你打开Word都有AI帮你写文案了,对吧?
至于未来会不会真的出来通用人工智能,那是十年后的事情了。我们先把这三五年的日子过好再说。 
