多模态大模型:AI产业落地的真风口还是伪概念?
上个月跟一个做AI创业的朋友喝夜酒,他把杯子往桌上一墩,满脸愁容。半年前拿着纯文本大模型的项目融了上千万,现在见客户,十有八九会被问一句:你这玩意能做多模态不?能看图片能分析视频不?做不出来,客户转头就走。
 真多模态与伪多模态大模型结构对比图
核心差异说穿了就是一句话:假多模态是"拼"出来的,真多模态是"训"出来的。
拼出来的假多模态,不仅推理延迟高,还经常错——比如你给它一张"带兔子的月亮"的图,让它讲一个中秋节的故事,它可能识别出月亮和兔子,但是理解不了两者和中秋节的关联,讲出来的东西驴唇不对马嘴。
真多模态就不会有这个问题,它能直接get到你图里藏的语义。
现在很多厂商拿着假多模态吹概念割融资,水很深,新手容易被骗。
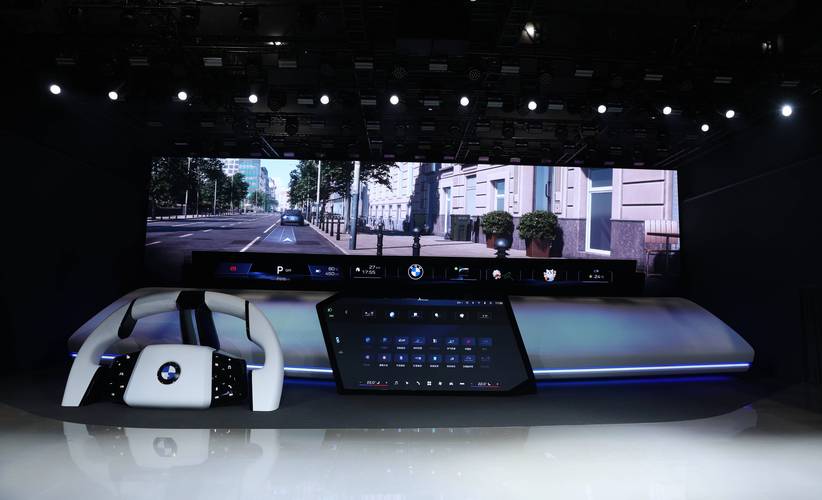 多模态大模型新能源汽车座舱交互场景实拍
然后是工业质检。国内不少头部汽车零部件厂,已经在用多模态大模型做缺陷检测了。原来的单模态AI只能按照固定特征识别缺陷,遇到没见过的新缺陷直接歇菜。现在工人拍一张缺陷的照片,加上自己的文字描述"这个裂纹在焊接处,长度大概两厘米",模型就能直接判断要不要报废,还能给出维修方案,准确率比原来的老系统高了快四成,一年能帮工厂省几百万的返工成本。
还有内容创作,短视频团队现在很多都用多模态剪片了。把raw素材全部扔进去,说"给我剪一个30秒的抖音种草视频,突出产品的颜值,配活泼的文案",模型能直接看懂每个片段的画面内容,自动剪好配好,比一个剪辑师干一天活还快。
不过话说回来,落地障碍也挺明显的。第一个就是贵。真多模态大模型的推理成本,是同级别纯文本大模型的2到3倍,普通中小企业想用都用不起,现在也就头部互联网和大制造业敢用。第二个是数据问题,高质量的合规多模态训练数据太少,买得起的没几家,版权问题还扯不清。
 未来3到5年,哪些人能吃到红利?
先讲风险,多模态的治理难度比纯文本大太多了。
文字违规,关键词一挡基本就搞定了。多模态呢?你发一张带敏感内容的图,或者把敏感信息藏在图片的纹理里,模型很容易漏过。还有现在的deepfake,借着多模态技术,逼真程度已经到了普通人完全分不出来的地步,造谣诽谤的成本越来越低,这是绕不开的伦理问题。
回到产业,未来3年,多模态会变成所有大模型的标配。再也不会有新的纯文本通用大模型出来了,所有玩家都会做多模态,这是确定性的趋势。
那机会在哪?
很多人觉得只有巨头能玩,不对。垂直领域的小而美多模态模型,机会大得很。比如专门做医疗多模态的,把CT影像和病历文本放在一起训练,帮医生写诊断报告,准确率比通用多模态高太多,医院愿意掏钱。再比如专门做电商多模态的,用户拍一张自己穿衣服的图,搜同款同款,比搜文字准多了,平台抢着要。
再过5年,我们跟AI的交互方式会彻底变。现在你跟AI聊天还要打字,未来你随手拍个照,发一段语音,甩一个视频片段,直接说你要什么就完了。多模态才是真正符合人类自然交互习惯的AI,原来的纯文本交互,反而只是过渡阶段。
我最近见了好几个垂直多模态的创业者,他们没拿多少融资,闷头在细分领域干,已经实现正向现金流了。反而那些拿着大笔融资吹通用多模态概念的,不少还在找方向。
潮水退了,才知道谁在裸泳。多模态是真风口,但也容不下骗钱的伪概念。
别被概念忽悠:分清真多模态和伪多模态
现在圈内打开PPT,十个AI项目九个说自己做多模态。说实话,九成九都是拼出来的假玩意。 什么是假的?就是我做一个图像识别模型,做一个文本大模型,中间加个转换模块,识别完图片转成文字再交给大模型处理,就敢管自己叫多模态大模型了。对吧? 真正的多模态大模型,从预训练阶段就把文本、图像、音频、视频等不同模态的数据放在一起训练,所有模态共享同一个语义向量空间。它不用转换,直接就能理解"这张图里的狗"和"我文本说的狗"是同一个东西,能直接找到不同模态信息之间的关联。真多模态与伪多模态大模型结构对比图
核心差异说穿了就是一句话:假多模态是"拼"出来的,真多模态是"训"出来的。
拼出来的假多模态,不仅推理延迟高,还经常错——比如你给它一张"带兔子的月亮"的图,让它讲一个中秋节的故事,它可能识别出月亮和兔子,但是理解不了两者和中秋节的关联,讲出来的东西驴唇不对马嘴。
真多模态就不会有这个问题,它能直接get到你图里藏的语义。
现在很多厂商拿着假多模态吹概念割融资,水很深,新手容易被骗。
已经落地的真实场景,到底赚不赚钱?
别觉得多模态还是实验室里的东西,其实不少场景已经跑通了。 最成熟的要数智能座舱。现在新推出的二十万以上的新能源车型,基本都标配了多模态交互。你开车的时候,拍一张路边的广告牌发给车机,说"导航去这家店",车机能直接识别广告牌上的地址,不用你手动输入,也不用语音再念一遍。遇到看不懂的路牌,拍个照就能问模型,太方便了。多模态大模型新能源汽车座舱交互场景实拍
然后是工业质检。国内不少头部汽车零部件厂,已经在用多模态大模型做缺陷检测了。原来的单模态AI只能按照固定特征识别缺陷,遇到没见过的新缺陷直接歇菜。现在工人拍一张缺陷的照片,加上自己的文字描述"这个裂纹在焊接处,长度大概两厘米",模型就能直接判断要不要报废,还能给出维修方案,准确率比原来的老系统高了快四成,一年能帮工厂省几百万的返工成本。
还有内容创作,短视频团队现在很多都用多模态剪片了。把raw素材全部扔进去,说"给我剪一个30秒的抖音种草视频,突出产品的颜值,配活泼的文案",模型能直接看懂每个片段的画面内容,自动剪好配好,比一个剪辑师干一天活还快。
不过话说回来,落地障碍也挺明显的。第一个就是贵。真多模态大模型的推理成本,是同级别纯文本大模型的2到3倍,普通中小企业想用都用不起,现在也就头部互联网和大制造业敢用。第二个是数据问题,高质量的合规多模态训练数据太少,买得起的没几家,版权问题还扯不清。
未来3到5年,哪些人能吃到红利?
未来3到5年,哪些人能吃到红利?
先讲风险,多模态的治理难度比纯文本大太多了。
文字违规,关键词一挡基本就搞定了。多模态呢?你发一张带敏感内容的图,或者把敏感信息藏在图片的纹理里,模型很容易漏过。还有现在的deepfake,借着多模态技术,逼真程度已经到了普通人完全分不出来的地步,造谣诽谤的成本越来越低,这是绕不开的伦理问题。
回到产业,未来3年,多模态会变成所有大模型的标配。再也不会有新的纯文本通用大模型出来了,所有玩家都会做多模态,这是确定性的趋势。
那机会在哪?
很多人觉得只有巨头能玩,不对。垂直领域的小而美多模态模型,机会大得很。比如专门做医疗多模态的,把CT影像和病历文本放在一起训练,帮医生写诊断报告,准确率比通用多模态高太多,医院愿意掏钱。再比如专门做电商多模态的,用户拍一张自己穿衣服的图,搜同款同款,比搜文字准多了,平台抢着要。
再过5年,我们跟AI的交互方式会彻底变。现在你跟AI聊天还要打字,未来你随手拍个照,发一段语音,甩一个视频片段,直接说你要什么就完了。多模态才是真正符合人类自然交互习惯的AI,原来的纯文本交互,反而只是过渡阶段。
我最近见了好几个垂直多模态的创业者,他们没拿多少融资,闷头在细分领域干,已经实现正向现金流了。反而那些拿着大笔融资吹通用多模态概念的,不少还在找方向。
潮水退了,才知道谁在裸泳。多模态是真风口,但也容不下骗钱的伪概念。 
