车间里的边缘计算实时推理:20年工程师踩坑总结的实招
昨天后半夜我刚换完工作服准备走。
班长拎着对讲机就冲过来,喊我去东边数控车间。
上次那批给车企做的45钢输出轴,云平台刚走了一半数据传输,机床自己停了。
我跑过去一看,屏幕上弹出来红框:当前刀具磨损量超阈值,推理结果不合格。
放在半年前,这批120根轴都得车完拉去三坐标全检,少说废15根,十几万的料就打了水漂。
那天只停了一根,换完刀接着干。
救场的就是那台刚装了三个月的边缘计算实时推理盒子。
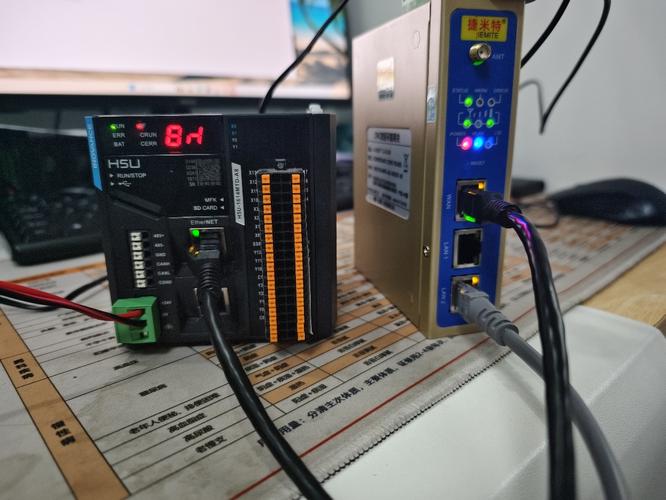 机械加工车间边缘计算推理网关安装实拍
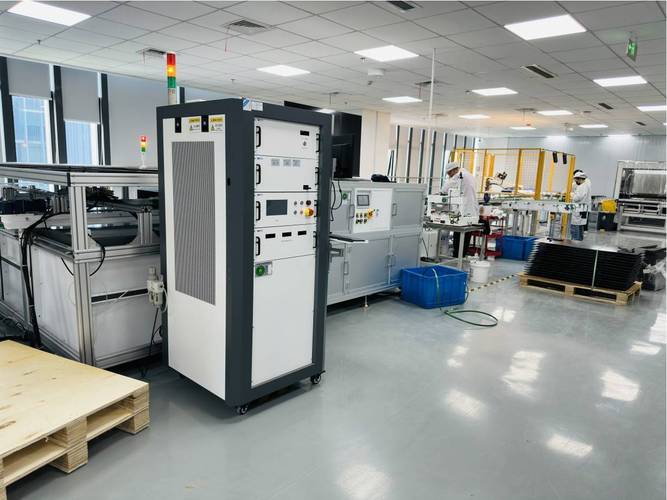 光伏硅片边缘AI分拣设备工作现场图
 风口下面藏着看不见的暗坑
现在都讲智能制造,进口替代,好多原来用进口边缘盒子的厂子,都换成国产的了。
我看这两年的趋势,就是越做越小,越做越省电,原来进口盒子一台三百瓦,现在国产NPU盒子才五十瓦,一天二十四小时开着,一年省出不少电费,刚好踩了绿色制造的点。
不过话说回来,行业里有个不愿公开说的难题。
最大的暗坑其实是模型漂移。
什么意思?车间每个批次的材料硬度不一样,夏天冬天的机床温度不一样,用了三个月之后,原来准确率99%的模型,可能掉到95%以下,错漏一大堆。
卖设备的厂家卖的时候从来不提这个,等你出问题了,就说要更新模型,得每年交好几万的服务费,不交就不给更。
好多中小厂子贪便宜买了,用半年就扔在一边当普通网关用,白扔了十几万。
还有个风险是标准滞后,现在整个行业没有统一的接口标准,你买了A家的边缘盒,就只能用A家的模型,想换B家的,整个系统都得换,绑定得死死的,以后涨价你都没地方说理去。
我今天早上擦机床的时候,还跟徒弟说。
“再好的牛犁,也要跟着地走。”
哪有什么万能的边缘计算实时推理?你做百万级批量生产的,就上专用NPU卡,精度够还省电。你做小批量多品种的,就用x86盒子,改模型方便不折腾。
别听厂商瞎吹什么大算力全功能,适合你场子活的,才是真的好。
你们场子上边缘推理的时候,踩过什么离谱的坑?不妨出来唠唠。
堆在车间油污里摸出来的道理
很多人听这名觉得玄乎,不就是把AI模型放机床边上跑吗? 其实核心要求就那几个,干我们这行的,先讲死规矩。 第一,推理延迟必须控制在100ms以内。 晚了,机床都切完下一刀了,你再报警有屁用? 第二,边缘盒的INT8算力不用瞎堆,超过16TOPS就是浪费钱,咱们车间加工零件,识别个磨损、量个尺寸,根本用不到那么大算力。 第三,模型必须压缩,压缩率得做到90%以上,不然塞不下边缘那点存储,跑起来还卡。 现在市面主流两种路线,一种是通用x86架构的边缘盒,一种是专用NPU加速的。 x86好处是啥?你换个产品换个模型,直接拖进去就能跑,不用重新编译适配,省折腾。 但坏处也明显,功耗高,动不动两百多瓦,车间夏天不开空调的话,四十多度连跑三天,大概率掉驱动蓝屏。 NPU呢,功耗低,延迟稳,同样算力体积还小,好装在机床控制柜里。 可每次改模型都要做算子适配,少则三天多则一周,赶订单的时候能把你急死。 说实话,行业内通常不说但实际都在做的妥协是什么? 就是中小工厂别追满配算力,留个20%的余量足够用,真要训模型,没人从零开始搞,都是拿大厂预训练好的模型改改输出层,凑合用,准确率差个1%根本不影响生产,省下来的时间和钱,够多买两把进口刀了。机械加工车间边缘计算推理网关安装实拍
不同场子,完全不一样的要求
我干了20年机加工,上个月去常州拜访朋友,看了光伏厂的应用,才知道差别多大。 先说说我们机加工这行,最常见的就是在线刀具磨损检测。 我们厂装了这套之后,原来每20件抽一件检测,现在每切一件都做实时推理,尺寸飘了立刻停刀。 上个月统计,废活率从原来的1.2%直接掉到0.1%以下,一个月省出来的料钱,就够付一半盒子钱了。 我们这行的核心要求是什么?抗造。 车间里有切削液油污,机床开着就振,你那盒子娇气得天天维护,那肯定不行。 换了光伏硅片分拣就不一样了。 朋友那个厂做182硅片,分拣线速度是120片每分钟,每片都要查隐裂、划痕、线痕,容不得错。 要是把数据传到云端推理,光传输延迟就大几百毫秒,整条线都得堵。 上了边缘计算实时推理之后,所有识别都在生产线侧完成,延迟压到30ms以内,分拣准确率从原来的98.5%升到99.7%,一年下来多卖出去的合格硅片,算下来快两百万。 人家这行的要求就是快,对识别精度抠得死,差一点都不行。光伏硅片边缘AI分拣设备工作现场图
风口下面藏着看不见的暗坑
风口下面藏着看不见的暗坑
现在都讲智能制造,进口替代,好多原来用进口边缘盒子的厂子,都换成国产的了。
我看这两年的趋势,就是越做越小,越做越省电,原来进口盒子一台三百瓦,现在国产NPU盒子才五十瓦,一天二十四小时开着,一年省出不少电费,刚好踩了绿色制造的点。
不过话说回来,行业里有个不愿公开说的难题。
最大的暗坑其实是模型漂移。
什么意思?车间每个批次的材料硬度不一样,夏天冬天的机床温度不一样,用了三个月之后,原来准确率99%的模型,可能掉到95%以下,错漏一大堆。
卖设备的厂家卖的时候从来不提这个,等你出问题了,就说要更新模型,得每年交好几万的服务费,不交就不给更。
好多中小厂子贪便宜买了,用半年就扔在一边当普通网关用,白扔了十几万。
还有个风险是标准滞后,现在整个行业没有统一的接口标准,你买了A家的边缘盒,就只能用A家的模型,想换B家的,整个系统都得换,绑定得死死的,以后涨价你都没地方说理去。
我今天早上擦机床的时候,还跟徒弟说。
“再好的牛犁,也要跟着地走。”
哪有什么万能的边缘计算实时推理?你做百万级批量生产的,就上专用NPU卡,精度够还省电。你做小批量多品种的,就用x86盒子,改模型方便不折腾。
别听厂商瞎吹什么大算力全功能,适合你场子活的,才是真的好。
你们场子上边缘推理的时候,踩过什么离谱的坑?不妨出来唠唠。 
